Ein in virtuellen Wohnungen trainierter Roboter bewährt sich in echten Räumen
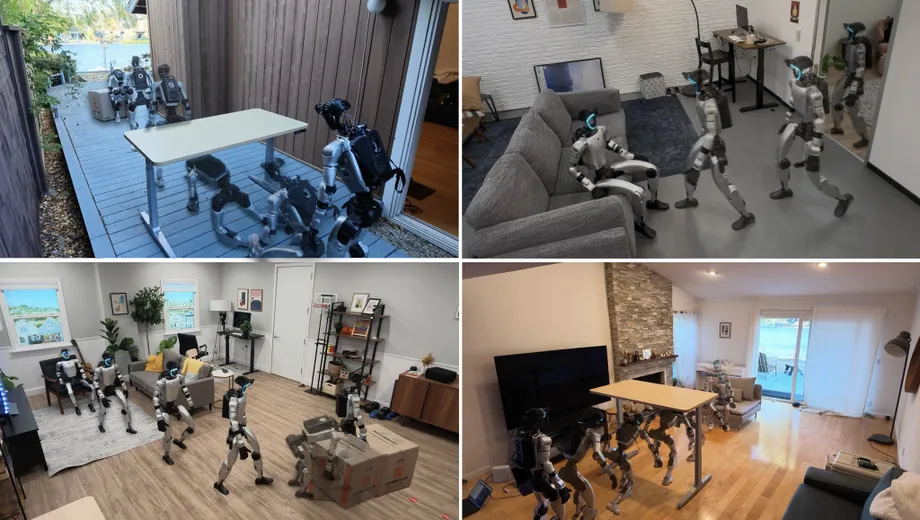
Apple-Forschende berichten, dass ihr humanoides Steuerungssystem HALO bei einzelnen physischen Aufgaben über 360 Versuche hinweg eine durchschnittliche Erfolgsquote von 91 Prozent in sechs realen Umgebungen erreicht hat, die zuvor weder gescannt noch kartiert worden waren. Das auf einem Unitree Robotics G1 laufende System nutzte Erfahrungen aus Simulationen, um sich in unbekannten Räumen zu bewegen, auf Möbeln Platz zu nehmen, enge Durchgänge zu passieren und Kisten zu schieben.
Inhalt
- Ein in virtuellen Wohnungen trainierter Roboter bewährt sich in echten Räumen
- Was das Ergebnis von 91 Prozent umfasst
- Warum längere Anweisungen schwieriger sind
- Drei Ebenen setzen eine Aufforderung in Bewegung um
- Ein Mac mini fährt auf dem G1 mit
- Wie 1.000 virtuelle Wohnungen Trainingsbeispiele liefern
- Rechenaufwand und menschliche Arbeit
- Das Sehen löst das Kontaktproblem noch nicht
- Was die Forschung verändert
- Die wichtigsten Punkte
Die Ergebnisse sind in der am 4. November 2026 bei arXiv eingereichten Studie Perceptive Humanoid Motion from Simulation zu finden. Das Paper des Apple-Teams beschreibt ein Training mit rund 300 Stunden synthetischer Beispiele aus 1.000 computergenerierten Wohnumgebungen. Anschließend wurde das System direkt auf einen physischen Roboter übertragen.
Längere Aufgaben waren schwieriger. In einer separaten realen Umgebung erzielte HALO bei drei Kombinationen von Aktionen, die jeweils zehnmal getestet wurden, im Durchschnitt eine Erfolgsquote von 70 Prozent. Die Abfolge, bei der der Roboter unter einem Hindernis hindurchtauchen, sich einem Ziel nähern und eine Kiste schieben musste, gelang in fünf von zehn Versuchen.
Der praktische Fortschritt liegt darin, das Verstehen einer Aufforderung mit der Bewegung eines ganzen Körpers durch eine unbekannte Möblierung zu verbinden. Für einen Befehl wie „Setz dich auf einen Stuhl“ muss der Roboter den Sitz erkennen, einen Weg dorthin finden, seinen Körper ausrichten und beim Hinsetzen das Gleichgewicht halten. HALO verteilt diese Aufgaben auf drei zusammenarbeitende Steuerungsebenen.
Die Autoren sind Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller und Vladlen Koltun; alle sind mit Apple verbunden. Sie veröffentlichten außerdem den Code für Datengenerierung, Training und Einsatz des Systems, einschließlich Aufgabenplanung, Bewegungserzeugung und Bewegungsverfolgung in Simulationen und auf physischen Robotern.
Was das Ergebnis von 91 Prozent umfasst
Die sechs einzelnen Fertigkeiten wiesen unterschiedliche Erfolgsquoten auf. Am besten schnitt das Ducken ab, am wenigsten erfolgreich war das Hinsetzen:
- Zu einem benannten Objekt gehen: 92 Prozent.
- Auf einem Möbelstück Platz nehmen: 85 Prozent.
- Durch eine teilweise geöffnete Tür gehen: 93 Prozent.
- Unter einem Hindernis hindurchducken: 100 Prozent.
- Unter einem Hindernis hindurchkriechen: 90 Prozent.
- Eine Kiste schieben: 88 Prozent.
Zwischen Ducken und Hinsetzen lagen 15 Prozentpunkte. Beim Hinsetzen reicht es nicht, den richtigen Ort zu erreichen: Der Roboter muss sich zum Möbelstück ausrichten und sein Gewicht auf die Sitzfläche verlagern. Das stellt Anforderungen an sein visuelles Verständnis ebenso wie an seine physische Steuerung.
Alle sechs Testumgebungen waren für HALO unbekannt. Die Forschenden hatten sie weder zuvor gescannt noch im Training verwendet. Im Paper ist von Zero-Shot-Transfer die Rede. Das bedeutet, dass das System ohne zusätzliches Training für die jeweiligen Zielorte vom simulierten Training auf diese realen Umgebungen übertragen wurde.
Demonstrationen zeigen außerdem, wie der G1 einer Person folgt, sich auf ein Sofa setzt, seitwärts durch eine teilweise geöffnete Tür geht und sich unter einem Tisch duckt oder hindurchkriecht. Diese Bewegungen veranschaulichen, wie das System seine Körperhaltung an den verfügbaren Raum anpasst, statt einfach nur auf ein Ziel zuzulaufen.
Warum längere Anweisungen schwieriger sind
Bei den drei Aufgabenabfolgen von HALO fielen die Ergebnisse unterschiedlich aus. Die Kombination aus dem Durchqueren einer Tür und dem anschließenden Gehen zu einem Ziel gelang in allen zehn Versuchen. Die Abfolge aus Ducken und Hinsetzen gelang sechsmal. Beim Ducken, Annähern an ein Ziel und Schieben einer Kiste waren es fünf erfolgreiche Versuche.
Zusammen waren damit 21 von 30 Aufgabenabfolgen erfolgreich, also 70 Prozent. Das liegt 21 Prozentpunkte unter dem Durchschnitt bei einzelnen Aufgaben, auch wenn die Tests der Abfolgen in einer anderen Umgebung und mit weniger Versuchen durchgeführt wurden.
Bei einer Abfolge gibt es mehr Gelegenheiten für Probleme, denn das Ergebnis einer Bewegung bestimmt die Ausgangsposition für die nächste. Nach dem Hindernis muss der Roboter beispielsweise noch in der Lage sein, sein Ziel anzusteuern und die nächste Bewegung auszuführen.
HALO begegnet dem mit visuellen Prüfungen. Der Planer wertet Videos aus der Perspektive des Roboters aus, beurteilt, ob die aktuelle Aktion gelungen ist, und entscheidet, ob er weitermachen oder sie wiederholen soll. Die Ergebnisse zeigen, dass das Verknüpfen nützlicher Fertigkeiten anspruchsvoller bleibt als ihre getrennte Ausführung.
Drei Ebenen setzen eine Aufforderung in Bewegung um
Die oberste Steuerungsebene übernimmt die Aufgabenplanung. Sie nutzt ein Vision-Language-Modell, also eine KI, die Bilder und Wörter verarbeitet, um eine Aufforderung zusammen mit dem Kamerabild zu interpretieren. Standardmäßig kommt Qwen3.6-35B-A3B zum Einsatz, das lokal auf einem vom Roboter getragenen Mac mini läuft.
Der Planer wird alle zwei Sekunden aufgerufen. Bittet jemand den Roboter, sich hinzusetzen, ohne einen Sitzplatz zu nennen, muss er ein geeignetes sichtbares Objekt auswählen. Versperrt ein Tisch den Weg zu einem Stuhl, kann er die Aufforderung in kleinere Aktionen aufteilen: unter dem Hindernis durchtauchen, zum Stuhl gehen und sich hinsetzen.
Die mittlere Ebene übersetzt jede Teilaufgabe in einen Bewegungsplan. Sie kombiniert Qwen3.5-2B, dessen Encoder-Parameter während des Trainings unverändert bleiben, mit einem Diffusion-Transformer-Decoder, der Ganzkörperbewegungen erzeugt. Ein Encoder wandelt Bild und Anweisung in eine für das Bewegungsmodell nutzbare Repräsentation um; der Decoder erzeugt daraus die geplanten Körperhaltungen.
Diese Ebene plant ungefähr fünf Sekunden voraus und berechnet etwa dreimal pro Sekunde einen neuen Plan. Sie aktualisiert die vorgesehene Bewegung also anhand neuer Kamerabilder, statt eine ganze Fünf-Sekunden-Aktion ohne Blick auf die Umgebung auszuführen.
Die unterste Ebene, der sogenannte Motion Tracker, übersetzt die Pläne 50-mal pro Sekunde in Gelenkbefehle. Er kombiniert Tiefenbilder mit Informationen über Position und Bewegung des Roboters selbst. So kann er dem Plan folgen und zugleich Gleichgewicht, Kontakt und Motorgrenzen berücksichtigen.
Ein Mac mini fährt auf dem G1 mit
Im physischen Aufbau sitzt ein Mac mini mit M4-Pro-Chip und 64 GB gemeinsamem Arbeitsspeicher in einem Schutzgehäuse auf dem Rücken des G1. Der Computer führt die anspruchsvolleren Modelle für Aufgabenplanung und Bewegungserzeugung aus. Der integrierte Prozessor des G1 übernimmt den Motion Tracker.
An einer speziell angefertigten Halterung am Kopf sitzt eine OAK-1W-Kamera. Ihr Farbvideostream hat eine Auflösung von 1.280 mal 800 Pixeln, läuft mit 30 Bildern pro Sekunde und erfasst einen Sichtwinkel von 120 Grad. Das weite Sichtfeld hilft dem System, Möbel und Durchgänge in der Nähe zu erfassen, während sich der Roboter bewegt.
Der Roboter arbeitet ohne Kabelverbindung; seine Softwarekomponenten kommunizieren über ZeroMQ, ein Nachrichtensystem. Die lokale Standardkonfiguration funktioniert ohne Internetverbindung. Bei entsprechender Konfiguration kann HALO auch über eine Programmierschnittstelle auf ein Cloud-Modell zugreifen.
Die Verteilung der Rechenarbeit entspricht der Steuerungshierarchie. Eine Aufforderung muss nicht ständig neu verstanden werden, während ein sich bewegender Roboter sehr viel schneller stabilisiert werden muss. Während der Bewegungsplaner einen neuen Plan berechnet, führt der Tracker den aktuellen weiter aus. So muss der Roboter nicht jedes Mal anhalten, wenn das Modell eine Berechnung durchführt.
Wie 1.000 virtuelle Wohnungen Trainingsbeispiele liefern
Die Trainingspipeline von HALO nimmt sich eines konkreten Mangels an: Es gibt zu wenige Beispiele, die verbinden, was ein humanoider Roboter sieht, was er tun soll und wie sich sein ganzer Körper dafür bewegen muss. Gewöhnliche Videos zeigen zwar Handlungen, doch für das Training dieses Systems müssen die Bilder mit Anweisungen und detaillierten Roboterbewegungen verknüpft sein.
Die Autoren beschreiben den Zeitaufwand einiger Methoden, bei denen Demonstrationen durch menschliche Bedienung oder tragbare Aufzeichnungsgeräte gesammelt werden:
Weil eine Person jede Episode manuell vormachen muss, kostet eine Stunde an Daten mindestens eine Stunde menschlicher Arbeitszeit.
HALO erstellt stattdessen passende Beispiele in einer Simulation. Der Prozess beginnt mit einer Aufgabe, die in Bewegungsabschnitte unterteilt wird. Das Hinsetzen in einem Sessel kann beispielsweise aus Vorwärtsgehen, Umdrehen und Absenken auf den Sitz bestehen. Textanweisungen, Wegpunkte und Schlüsselposen dienen einem Bewegungsmodell namens Kimodo als Vorgaben.
Automatisierte geometrische Prüfungen bewerten anschließend mögliche Bewegungen auf Probleme wie rutschende Füße, durch den Boden dringende Körper, plötzliche Sprünge und Gelenke, die ihre Grenzwerte überschreiten. Die Pipeline behält den besten Kandidaten und platziert die Bewegung in einem virtuellen Raum.
Infinigen, ein Generator für prozedurale Szenen, erstellt 1.000 Umgebungen mit unterschiedlichen Grundrissen und Möbeln, darunter Wohnzimmer, Büros und Schlafzimmer. Das System sucht nach Positionen, bei denen die geplante Bewegung und das Zielobjekt des Roboters ohne Zusammenstoß mit den umgebenden Möbeln zusammenpassen.
Anschließend rendert ein Simulator, was der Roboter während der Aktion sehen würde. Dafür verwendet er eine simulierte Fischaugenkamera, die der physischen Kamera nachempfunden ist. Variationen bei Beleuchtung, Belichtung, Farbe, Kontrast, Unschärfe und Sensorrauschen sorgen für abwechslungsreichere Bilder. Jedes fertige Beispiel verknüpft eine Anweisung, ein Kamerabild und die dazugehörige Körperbewegung.
Rechenaufwand und menschliche Arbeit
Für die Erstellung des zentralen Trainingsdatensatzes wurden mit 250 Nvidia-H100-Grafikprozessoren etwa 48 Stunden benötigt. Diese Prozessoren, meist GPUs genannt, führen viele Berechnungen parallel aus und ermöglichen so die gleichzeitige Erzeugung großer Mengen simulierter Daten.
Der Aktionsgenerator wurde mit Imitationslernen und 64 Nvidia-B200-GPUs trainiert. Beim Imitationslernen lernt ein Modell, vorgegebene Verhaltensweisen nachzuahmen. Für das Training des Motion Trackers kamen vier H100-GPUs zum Einsatz; dabei wurden bestärkendes Lernen und Policy-Distillation kombiniert.
Beim bestärkenden Lernen wird ein Steuerungssystem durch Versuche und Rückmeldungen darüber trainiert, wie gut es sich schlägt. Policy-Distillation überträgt erlerntes Verhalten auf ein anderes Modell. Bei HALO helfen diese Methoden dem Tracker dabei, geplante Körperhaltungen in Bewegungen umzusetzen, die der physische Roboter ausführen kann.
Menschen definieren weiterhin Teile des Prozesses. Für eine neue physische Aufgabe müssen Anweisungen geschrieben und Schlüsselposen entworfen werden; manche Bewegungen basieren auf menschlichen Videos oder Motion-Capture-Material. Sobald diese Aufgabenbeschreibungen und Einschränkungen vorliegen, kann die Pipeline sie für viele generierte Räume wiederverwenden.
Die Änderung besteht also darin, wie Demonstrationen erweitert werden. Statt eine Person jede Episode vorführen zu lassen, setzt HALO Rechenleistung ein, um viele Varianten einer Aufgabe zu erzeugen und zu prüfen.
Das Sehen löst das Kontaktproblem noch nicht
HALO stützt sich derzeit hauptsächlich auf visuelle Wahrnehmung und kann Kontakte laut den Forschenden nicht direkt wahrnehmen. Die Leistung kann bei Aufgaben mit umfangreichem Körperkontakt nachlassen, wenn ein Objekt aus dem Kamerabild verschwindet oder von etwas anderem verdeckt wird.
Das Schieben einer Kiste zeigt, warum das wichtig ist. Der Roboter muss seinen Körper im richtigen Verhältnis zur Kiste halten, während sich beide bewegen. Eine Kamera liefert Informationen zur sichtbaren Position, während ein Tastsinn Informationen über den Kontakt liefern könnte, die auch dann nützlich bleiben, wenn die Sicht versperrt ist.
Die Forschenden nennen taktile Sensorik als eine mögliche Richtung für weitere Arbeiten. Einen Zeitplan für ihre Einführung gibt es nicht. Die aktuellen Ergebnisse markieren die Herausforderung klar: HALO kann mehrere visuell gesteuerte Fertigkeiten in unbekannten Räumen ausführen; längere Abläufe und Interaktionen mit Körperkontakt sind jedoch weniger zuverlässig.
Was die Forschung verändert
Die Studie von Apple vereint die Erzeugung von Trainingsdaten, sprachbasierte Planung und physische Steuerung in einem System, das auf einem humanoiden Roboter in zuvor unbekannten Räumen läuft. Das stärkste Ergebnis ist die Übertragung aus 1.000 simulierten Umgebungen auf 360 physische Versuche, ohne die sechs Testorte zuvor zu kartieren.
Der veröffentlichte Code stellt die Pipeline für weitere Forschungsarbeiten in Simulation und auf Hardware bereit. Dazu gehören sowohl die Werkzeuge zur Erzeugung von Trainingsbeispielen als auch die Modelle und Software für die Erzeugung, Verfolgung und Koordination von Bewegungen.
Wenn jemand einen Roboter bittet, sich hinzusetzen oder eine Kiste zu bewegen, hängt die Zuverlässigkeit davon ab, dass die gesamte Abfolge funktioniert: das richtige Objekt erkennen, es erreichen, Kontakt herstellen und die Bewegung ausführen. HALOs Ergebnisse bei einzelnen Aufgaben zeigen Fortschritte entlang dieser Abfolge. Die Ergebnisse der Aufgabenfolgen machen deutlich, woran noch gearbeitet werden muss, bevor sich mehrere Aktionen ebenso zuverlässig miteinander verbinden lassen.
Die wichtigsten Punkte
- Forschende von Apple reichten Perceptive Humanoid Motion from Simulation am 4. November 2026 bei arXiv ein.
- HALO erreichte bei 360 Versuchen mit einzelnen Aufgaben in sechs unbekannten, nicht kartierten realen Umgebungen eine durchschnittliche Erfolgsquote von 91 Prozent.
- Drei Aufgabenabfolgen erzielten in einer anderen realen Umgebung bei 30 Versuchen eine durchschnittliche Erfolgsquote von 70 Prozent.
- Das System kombiniert Aufgabenplanung und Bewegungserzeugung mit einem Tracker, der 50-mal pro Sekunde Gelenkbefehle ausgibt.
- Das Training nutzte rund 300 Stunden synthetischer Beispiele aus 1.000 generierten Umgebungen.
- Ein vom Unitree G1 getragener Mac mini ermöglicht den lokalen Betrieb ohne Internetverbindung.
- Die Entwicklung der Aufgaben durch Menschen bleibt Teil des Trainings; die begrenzte Wahrnehmung von Körperkontakt ist weiterhin eine Schwäche.