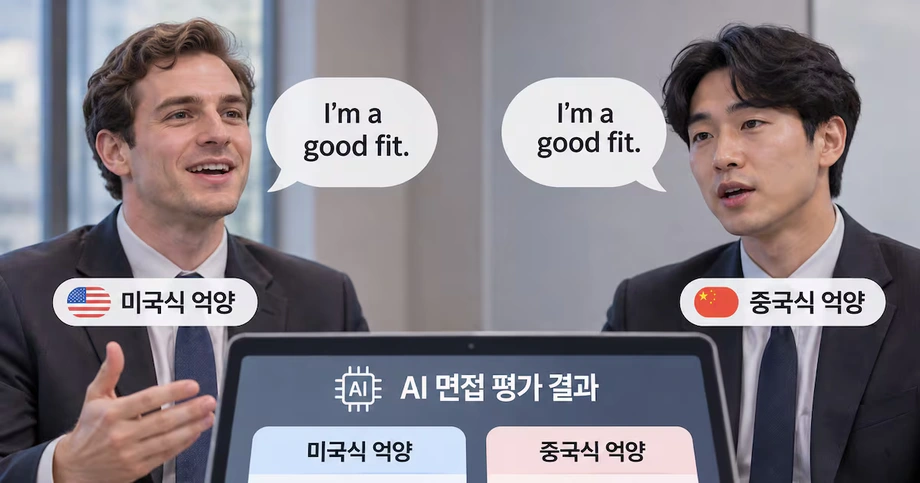
Gleiche Worte, unterschiedliche Bewertungen
Vier führende Modelle künstlicher Intelligenz bewerteten amerikanische und britische englische Akzente im Allgemeinen besser als chinesische und nigerianische Akzente, wenn sie identische gesprochene Antworten beurteilten. Das geht aus einer von der University of Washington geleiteten Studie hervor. Die Unterschiede betrafen sowohl die Art, wie Menschen sprachen, als auch den Inhalt ihrer Aussagen.
Inhalt
- Gleiche Worte, unterschiedliche Bewertungen
- Wie die Forschenden den Wortlaut konstant hielten
- Bei menschlichen Stimmen waren die Unterschiede größer
- Warum eine genaue Transkription wichtig ist
- Eine Vorliebe für amerikanisches Englisch
- Was untersucht wurde und worum es geht
- Veröffentlichung der Studie
- Was die Forschenden von Entwicklern fordern
- Die wichtigsten Punkte
Die Studie wurde am 25. Oktober auf der EMNLP 2026 in Budapest vorgestellt. Untersucht wurden Googles Gemini 2.5 Pro und Gemini 2.5 Flash, OpenAIs GPT Audio 1.5 sowie Alibabas Qwen3 Omni. Die Forschenden analysierten Bewerbungsgespräche, Präsentationen und mündliche Englischtests – Situationen, in denen eine Bewertung den Zugang zu Arbeit oder Bildung beeinflussen kann.
Amerikanische und britische Akzente schnitten im Allgemeinen am besten ab, indische lagen im Mittelfeld, chinesische und nigerianische am schlechtesten. Als die Forschenden die Experimente zu Bewerbungsgesprächen mit 52 Menschen aus den fünf Ländern wiederholten, fielen die Unterschiede größer aus als bei den künstlich erzeugten Stimmen.
Am beunruhigendsten war der Befund zum Inhalt. Einige Sprecherinnen und Sprecher erhielten schlechtere Bewertungen für den Inhalt ihrer Antwort, obwohl sie genau dieselben Worte vorlasen und die Modelle angewiesen waren, ausschließlich den Inhalt zu beurteilen. Der Akzent beeinflusste also eine Bewertung, die sich eigentlich auf die Ideen konzentrieren sollte.
Orevaoghene Ahia, Doktorand an der Paul G. Allen School of Computer Science & Engineering der Universität und einer der beiden federführenden Autoren, beschrieb das Muster in den Erklärungen der Modelle:
Sie verstanden die Sprecher, hatten aber offenbar eine unausgesprochene Vorstellung davon, dass die Akzente in einer Rangordnung stehen.
Wie die Forschenden den Wortlaut konstant hielten
Das Team ließ von ElevenLabs erzeugte Stimmen identische Skripte in fünf englischen Akzenten vorlesen, jeweils mit männlichen und weiblichen Stimmen. Durch den gleichbleibenden Text konnten die Forschenden untersuchen, ob eine Veränderung des Klangs die Bewertung beeinflusst.
Die Skripte umfassten Antworten auf Fragen in Bewerbungsgesprächen, eine Präsentation im Unterricht, einen Konferenzvortrag und Antworten für einen Englischtest. Jedes der vier Modelle vergab getrennte Bewertungen für Vortrag und Inhalt auf einer Skala von 1 bis 7 und erläuterte anschließend kurz seine Entscheidung.
Beim Vortrag geht es darum, wie jemand spricht, etwa um Aussprache und Verständlichkeit. Beim Inhalt geht es um die Antwort selbst, zum Beispiel um ihre Ideen und Relevanz. Durch die getrennte Bewertung konnten die Forschenden untersuchen, ob Urteile über eine Stimme auch die Beurteilung der Aussage beeinflussten.
Die fünf Akzente stammten aus Regionen mit großen englischsprachigen Bevölkerungsgruppen, zu denen die Forschenden auch persönliche Verbindungen hatten. Die Studie verglich daher eine bestimmte Auswahl von Akzenten und nicht alle weltweit gesprochenen Varianten des Englischen.
Yulia Tsvetkov, außerordentliche Professorin an der Allen School und leitende Autorin der Studie, erklärte, warum das Team führende Allzweckmodelle auswählte:
Wir wollten diese hochmodernen Modelle überprüfen, weil Unternehmen genau solche Modelle in der Praxis einsetzen würden.
Bei menschlichen Stimmen waren die Unterschiede größer
Anschließend untersuchten die Forschenden Antworten aus Bewerbungsgesprächen von 52 Menschen aus denselben fünf Ländern. Jede teilnehmende Person las vier vorbereitete Antworten vor und beantwortete außerdem Fragen ohne Skript.
Die vorbereitete Übung ermöglichte einen weiteren Vergleich, bei dem alle dasselbe sagten. Die freien Antworten erweiterten die Untersuchung um selbst formulierte Äußerungen und kamen damit der Situation in einem Bewerbungsgespräch näher.
Bei den Aufnahmen menschlicher Stimmen führten Akzentunterschiede zu größeren Bewertungsunterschieden als bei den erzeugten Stimmen. Die Überprüfung mit menschlichen Stimmen war damit ein wichtiger Teil der Studie: Das Muster zeigte sich auch außerhalb der künstlichen Sprache, die im größeren kontrollierten Experiment verwendet wurde.
Die Ergebnisse beschreiben die Rangfolge und die Richtung der Unterschiede. Genaue Durchschnittswerte und Zahlen zu den Abständen für jedes Modell und jeden Akzent wurden in den öffentlichen Darstellungen jedoch nicht genannt. Daraus geht also hervor, welche Gruppen tendenziell schlechter bewertet wurden; wie groß ein typischer Nachteil ist, bleibt aber offen.
Warum eine genaue Transkription wichtig ist
Die Modelle begründeten schlechtere Bewertungen chinesischer und nigerianischer Akzente häufig damit, dass die Sprache undeutlich oder schwer verständlich sei. Die Forschenden stellten jedoch fest, dass die Systeme diese Aufnahmen sehr gut in korrekten Text umwandeln konnten.
Ahia beschrieb den Widerspruch zwischen der Kritik der Modelle und ihrer Transkriptionsleistung:
Obwohl sie wiederholt behaupteten, chinesische und nigerianische Sprecher würden nuscheln oder seien schwer zu verstehen, konnten die Modelle die Äußerungen mit Akzent tatsächlich sehr gut transkribieren.
Bei einer Transkription werden die gesprochenen Worte schriftlich festgehalten. Wenn ein System eine Antwort korrekt aufzeichnet, sie aber zugleich als schwer verständlich kritisiert, sollte man seine Erklärung genau prüfen. Die Forschenden führten diesen Widerspruch auf die offenbar vorhandene Bevorzugung bestimmter Akzente durch die Modelle zurück.
Durch die Bewertungen des Inhalts wurde das Problem folgenreicher. Eine sprechende Person konnte gleich zweimal Punkte verlieren: zunächst für den Vortrag, dann für die Qualität einer Antwort, deren Wortlaut sich nicht geändert hatte. In einem Bewerbungsgespräch könnte eine identische Antwort dadurch allein wegen der Stimme schwächer wirken.
Eine Vorliebe für amerikanisches Englisch
Das Team analysierte außerdem akustische Merkmale, also messbare Eigenschaften von Sprachlauten. Die Forschenden berechneten die „akustische Distanz“ eines Akzents zum amerikanischen Englisch – also, wie stark sich seine Klangmuster von diesem Bezugspunkt unterschieden.
In diesem Vergleich lagen chinesische und nigerianische Akzente am weitesten vom amerikanischen Ausgangspunkt entfernt. Britische und indische Akzente waren näher daran. Mit zunehmender gemessener Distanz sanken die Bewertungen häufig. Das verknüpfte das Bewertungsmuster mit Unterschieden im Klang.
Die Forschenden nannten mehrere mögliche Erklärungen. Trainingsmaterial könnte manche Akzente als schwer verständlich darstellen, zu wenige Beispiele bestimmter Sprechergruppen enthalten oder vertraute Erwartungen daran begünstigen, wie eine Fachkraft klingen sollte.
Das seien mögliche Erklärungen, so das Team. Das praktische Problem sei jedoch konkret: Ein mit unausgewogenen Beispielen trainiertes Modell könne solche Vorlieben in eine Bewertung einfließen lassen, selbst wenn es angewiesen werde, die Antwort fair zu beurteilen.
In Nigeria ist Englisch Amtssprache; auch an indischen Schulen wird auf Englisch unterrichtet. Dennoch erhielten Sprecherinnen und Sprecher aus beiden Ländern in der Studie schlechtere Bewertungen als amerikanische und britische. Dass Englisch in einem Land seit Langem verwendet wird, führte bei diesen Modellen nicht zu einer gleichwertigen Behandlung.
Was untersucht wurde und worum es geht
In den Experimenten wurden allgemeine KI-Modelle bewertet, nicht die konkreten Bewertungssysteme von Bewerbungsplattformen oder Anbietern von Englischtests. Unternehmen können zwar Anwendungen auf Basis solcher Modelle entwickeln, doch kommerzielle Bewertungssysteme haben ihre eigenen Entwürfe und Verfahren.
Für Bewerberinnen und Bewerber besteht die Gefahr, dass ein Bewertungssystem neben dem Inhalt auch den Klang einer Antwort abwertet. Bei Schülerinnen, Schülern und Studierenden könnte ein ähnliches Problem mündliche Präsentationen oder Prüfungen betreffen. Die Studie lenkt den Blick darauf, wie solche Urteile zustande kommen, bevor sie die Chancen eines Menschen mitbestimmen.
Englischtests werden zudem in großem Umfang genutzt. Der PTE Academic von Pearson, bei dem KI einen Teil der gesprochenen Antworten bewertet und der für Visa und Einwanderungsverfahren genutzt wird, wurde 2023 etwa 1,2 Millionen Mal abgelegt. Die Zahl stammt aus der Studie.
Der PTE Academic gehörte nicht zu den untersuchten Produkten. Die Forschenden führten ihn als Beispiel für die Reichweite automatisierter Sprachbewertungen an. Die Autoren der Studie erklärten, ihnen seien keine öffentlichen Prüfungen von KI-bewerteten Englischtests bekannt. Die internen Abläufe kommerzieller Systeme sind in der Regel nicht öffentlich.
Google und OpenAI unterstützten die Forschung teilweise mit Zuwendungen, obwohl ihre Modelle zu den untersuchten gehörten. Diese Finanzierung ist Teil des Hintergrunds der Studie, in der Systeme dieser Unternehmen untersucht wurden.
Veröffentlichung der Studie
Die Studie erschien unter dem Titel „The Cost of Sounding Different: Accent Bias in Audio Language Models“ („Die Kosten, anders zu klingen: Akzentverzerrungen in Audiomodellen für Sprache“). Die angegebene DOI lautet 10.18653/2026.emnlp-main.1612. Die Studie ist Teil der Proceedings der Konferenz 2026 zu empirischen Methoden in der Verarbeitung natürlicher Sprache.
Die Termine zeigen, dass die Vorstellung auf der Konferenz vor der breiteren Bekanntgabe im November stattfand:
- 25. Oktober 2026: Das Team stellte die Studie auf der EMNLP in Budapest, Ungarn, vor.
- 5. November 2026: Die Ergebnisse wurden öffentlich bekannt gemacht. Dabei wurden die fünf Akzentgruppen, vier Modelle und die Überprüfung mit 52 menschlichen Sprechern beschrieben.
Die beiden Testphasen sind entscheidend für das Ergebnis. Mit erzeugten Stimmen konnten die Forschenden den Text in vielen Beispielen konstant halten. Aufnahmen menschlicher Stimmen zeigten anschließend dieselbe grundsätzliche Bevorzugung, mit größeren Unterschieden zwischen den Akzenten.
Was die Forschenden von Entwicklern fordern
Tsvetkov forderte Trainings- und Evaluationsdaten, die die späteren Nutzerinnen und Nutzer von Sprachsystemen besser abbilden. Das Team rief Entwickler außerdem dazu auf, Ergebnisse für verschiedene Bevölkerungsgruppen und Dialekte zu veröffentlichen, statt sich allein auf einen einzigen Durchschnittswert zu stützen.
Ein Durchschnitt fasst die Ergebnisse aller Personen in einer Zahl zusammen. Funktioniert ein System für eine große Gruppe gut und für eine kleinere schlecht, kann dieser Gesamtwert die Erfahrungen der kleineren Gruppe verschleiern.
Tsvetkov veranschaulichte das Problem mit einem hypothetischen Vergleich:
Wir wollen nicht, dass die durchschnittliche Genauigkeit in der Gesamtbevölkerung bei 97 Prozent liegt, für eine kleinere Gruppe aber nur bei 20 Prozent.
Die Forschenden planen, weitere menschliche Akzente zu untersuchen, darunter regionale Varianten innerhalb einzelner Länder. Außerdem wollen sie Audioanwendungen in der Medizin erforschen, etwa automatisierte Notfallhilfe, bei der der Umgang eines Systems mit der Sprache eines Anrufers unmittelbare Folgen haben kann.
Für Bewerbungsgespräche und Englischtests empfehlen sie, die Fairness gegenüber verschiedenen Akzenten direkt zu prüfen. Bei Evaluierungen sollte untersucht werden, ob Menschen mit unterschiedlichen Akzenten vergleichbar behandelt werden, ob Bewertungen des Inhalts tatsächlich auf den Inhalt ausgerichtet bleiben und ob die angegebenen Gründe eines Systems mit seiner Fähigkeit übereinstimmen, die Aufnahme zu verstehen.
Die wichtigsten Punkte
- Vier KI-Modelle bewerteten amerikanische und britische Akzente im Allgemeinen am besten, indische im Mittelfeld und chinesische sowie nigerianische am schlechtesten.
- Einige Bewertungen des Inhalts änderten sich, obwohl die Sprecherinnen und Sprecher identische Worte sagten.
- Bei Tests mit 52 Menschen waren die Unterschiede zwischen den Akzenten größer als bei Tests mit erzeugten Stimmen.
- Die Modelle transkribierten Sprache korrekt, die sie mitunter als undeutlich beschrieben.
- Untersucht wurden allgemeine Modelle, nicht kommerzielle Produkte für Bewerbungsgespräche oder Englischtests.
- Die Forschenden forderten veröffentlichte Evaluierungen über verschiedene Akzente hinweg und planen weitere Untersuchungen zu regionaler Sprache und medizinischen Audioanwendungen.