Funktionsfähige GPU und behaupteter Durchsatzvorsprung von 5 Prozent
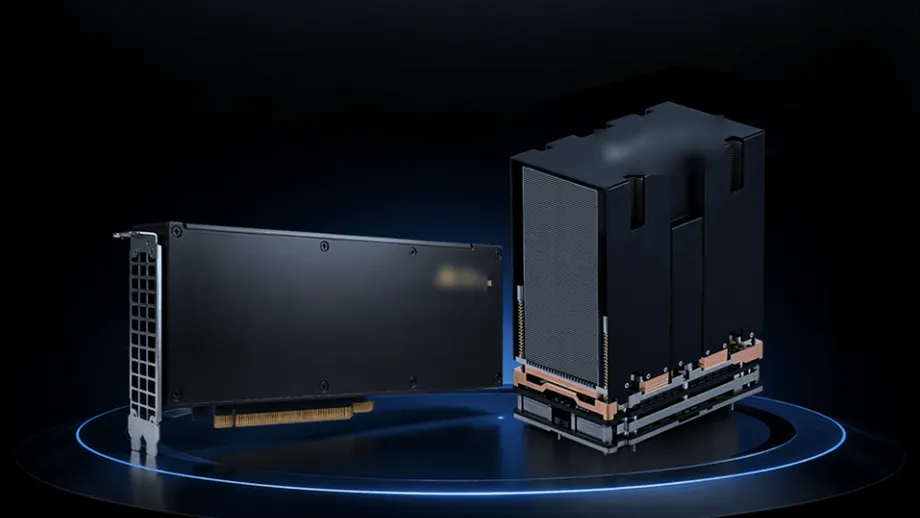
Iluvatar CoreX hat seinen Grafikprozessor Tiangai 300 in Shanghai öffentlich vorgeführt und ihn als chinesische Alternative zu Nvidias H200 präsentiert. In einem Inferenztest eines Drittanbieters soll der Chip um 5 Prozent besser abgeschnitten haben. Beim Medientag des Unternehmens am 28. Oktober 2026 waren außerdem ein Trainingssystem mit acht GPUs und ein Rack mit 144 GPUs und 18 CPUs zu sehen.
Inhalt
- Funktionsfähige GPU und behaupteter Durchsatzvorsprung von 5 Prozent
- Was der Vergleich mit dem H200 misst
- Lange Dokumente und schnellere erste Antworten
- Trainingsergebnisse mit anderer Nvidia-Referenz
- Von der Vorstellung im Juli zur Demonstration im Oktober
- Ein Rack mit 144 GPUs
- KI-Arbeit auf verschiedene Chips verteilen
- Software soll die Bereitstellungszeit verkürzen
- TY1200 erweitert das Angebot auf Robotik
- Die wichtigsten Punkte
Der viel beachtete Vergleich beruht laut Iluvatar CoreX auf Tests, die die Shanghai Electric Group im Juli abgeschlossen hat. Bei einer Bereitstellung, die zwei Phasen der Verarbeitung durch ein großes Sprachmodell voneinander trennte, erreichte der Tiangai 300 einen Ende-zu-Ende-Durchsatz in Höhe des 1,05-Fachen eines H200, nachdem die Ergebnisse auf eine Karte umgerechnet worden waren.
Durchsatz bezeichnet die Menge an nutzbarer Arbeit, die ein System in einer bestimmten Zeit erledigt. Bei einem Chatbot kann das bedeuten, wie viele Textstücke er pro Sekunde erzeugt. Ein Ergebnis vom 1,05-Fachen der Referenzleistung entspricht unter den Bedingungen dieses Tests einer um 5 Prozent höheren Ausgabe.
Das Unternehmen bezeichnete den Tiangai 300 als erste chinesische Allzweck-GPU, die in gemessenen Tests die Leistung eines H200 erreicht habe. Bei der Demonstration im Oktober wurde der Vergleich auf Sprachmodelle, Bildgenerierung und Videogenerierung ausgeweitet. Eine separate Trainingsdemonstration verwendete Nvidias H100 als Referenz.
Bei der Veranstaltung ging es um mehr als nur die technischen Daten eines Chips. Iluvatar CoreX präsentierte Karten, Server, ein dicht bestücktes Rack, Softwarewerkzeuge und eine Methode, KI-Arbeit auf verschiedene Prozessortypen zu verteilen. Das kommerzielle Versprechen des Unternehmens lautet, dass diese Komponenten gemeinsam nutzbare KI-Ergebnisse kostengünstiger und mit kürzeren Wartezeiten liefern können.
Was der Vergleich mit dem H200 misst
Beim Test der Shanghai Electric Group im Juli wurden Prefill und Decode voneinander getrennt, oft als PD-Trennung bezeichnet. Beim Prefill liest ein Sprachmodell die Anfrage eines Nutzers und die dazugehörigen Informationen ein. Beim Decode erzeugt es eine Antwort, Token für Token. Token sind die kleinen Einheiten, in die KI-Systeme Text zerlegen.
Durch die Trennung dieser Phasen lassen sich für das Lesen und Schreiben unterschiedliche Ressourcen zuweisen. Das Ergebnis des Tiangai 300 bezieht sich daher auf eine bestimmte Bereitstellungskonfiguration; die Gesamtleistung wird als entsprechender Wert für eine Karte angegeben.
Iluvatar CoreX hat die detaillierte Testmethode, die Modellliste und die Bedingungen der Arbeitslast für das viel beachtete Ergebnis des Drittanbieters nicht veröffentlicht. Diese Angaben sowie die Berechnung zur Umrechnung und die Softwareeinstellungen sind nötig, damit sich der Test unabhängig wiederholen lässt. Auch zur Kostenvergleichsrechnung gibt es keine veröffentlichte Aufschlüsselung. Zudem müssen die Speicherangaben für einzelne Karten und das komplette Rack genauer erläutert werden.
Die genannten Demonstrationen des Performance-Labors zeichnen ein genaueres Bild der Unternehmensangaben. Sie beschreiben je nach Aufgabe unterschiedliche Verbesserungen: von einem kleinen Zuwachs bei der Multimedia-Generierung bis hin zu einem deutlich höheren Durchsatz bei Empfehlungen. Für potenzielle Käufer ist entscheidend, wie der Vergleich bei den Aufgaben ausfällt, die ihr eigener Dienst tatsächlich ausführt.
Lange Dokumente und schnellere erste Antworten
Die Attention-Leistung des Tiangai 300 erreichte bei einer Kontextlänge von 64K laut dem Labor des Unternehmens das 1,05-Fache der H200-Leistung. Attention ist der Prozess, mit dem ein Modell ermittelt, welche Teile seiner Eingabe miteinander zusammenhängen. Bei einer Kontextlänge von 64K verarbeitet das Modell rund 64.000 Token.
Bei GLM-5.3 und derselben Kontextgröße gab Iluvatar CoreX einen Durchsatz in Höhe des 1,15-Fachen der H200-Leistung bei gleichbleibender Nutzererfahrung an. Das entspricht einem Zuwachs von 15 Prozent bei der getesteten Arbeitslast eines Mixture-of-Experts-Modells. Ein solches Modell leitet Aufgaben an ausgewählte spezialisierte Netzwerke weiter, anstatt bei jedem Token alle Netzwerke zu nutzen.
Bei KI-Agenten mit Kontexten von 8K bis 128K meldete das Unternehmen eine um etwa 10 bis 30 Prozent kürzere Wartezeit bis zum ersten Ausgabetoken. Dieser Wert ist für Nutzer relevant, die darauf warten, dass ein Assistent nach dem Einlesen eines langen Dokuments oder der Verarbeitung einer komplexen Anfrage mit der Antwort beginnt.
Auch die Bild- und Videogenerierung war Teil der Demonstration. Das Unternehmen meldete gegenüber dem H200 einen um etwa 2 bis 5 Prozent höheren Durchsatz bei der multimodalen Generierung. Bei Arbeitslasten für Online-Suche, Werbung und Empfehlungen behauptete es einen um 21 Prozent höheren Inferenzdurchsatz bei Empfehlungen und eine um 26 Prozent geringere Latenz bei leichtgewichtigen Berechnungen.
Trainingsergebnisse mit anderer Nvidia-Referenz
Bei der Trainingsdemonstration kam Qwen3-32B, ein Modell mit rund 32 Milliarden Parametern, auf einem Server mit acht GPUs zum Einsatz. Parameter sind die Zahlenwerte, die ein Modell während des Trainings anpasst, um Muster zu lernen. Iluvatar CoreX zufolge erreichte der effektive Durchsatz pro Karte das 1,33-Fache des Nvidia H100.
Der gemeldete Leistungsvorsprung betrug bei dieser Trainingsdemonstration also 33 Prozent; als Vergleichschip diente der H100. Bei den anderen Inferenztests der Veranstaltung wurde der H200 herangezogen. Um die Zahlen richtig einzuordnen, müssen diese Referenzprodukte getrennt betrachtet werden.
Das Trainingssystem arbeitete mit FP8-Präzision. FP8 speichert Zahlen mit acht Bit und verringert damit im Vergleich zu Formaten mit mehr Bits die zu übertragende und zu verarbeitende Datenmenge. Die KI-Trainingssoftware muss mit dieser geringeren Präzision sorgfältig umgehen, damit die Qualität des Lernprozesses erhalten bleibt.
Iluvatar CoreX meldete außerdem bei längerem Betrieb unter Volllast eine Schwankung der Schrittzeit von 0,43 Prozent, verglichen mit 0,76 Prozent bei einem Referenzsystem auf Hopper-Basis. Die Schrittzeit ist die Dauer, die für eine wiederholte Arbeitseinheit benötigt wird. Gleichmäßigere Zeiten können Betreibern helfen, abzuschätzen, wie viel Arbeit ein stark ausgelastetes System erledigen wird.
Von der Vorstellung im Juli zur Demonstration im Oktober
Der Tiangai 300 wurde im Juli 2026 auf der World Artificial Intelligence Conference offiziell vorgestellt. Er basiert auf der Tianshu-Architektur des Unternehmens, verfügt über Tensor Cores einer neuen Generation und ist mit 144 GB Grafikspeicher spezifiziert.
Der Prozessor unterstützt Skalar-, Vektor- und Tensoroperationen. Vereinfacht gesagt verarbeiten diese einzelne Zahlen, Zahlengruppen und größere mathematische Arrays. Zu den unterstützten Zahlenformaten gehören FP4, FP8, FP16 und BF16. Damit haben Softwareentwickler verschiedene Möglichkeiten, Geschwindigkeit, Speicherbedarf und numerische Präzision abzuwägen.
Die vom Unternehmen genannten öffentlichen Meilensteine erstrecken sich über mehrere Monate:
- Juli 2026: Der Tiangai 300 wurde auf der World Artificial Intelligence Conference vorgestellt.
- Juli 2026: Die Shanghai Electric Group schloss den Drittanbietertest ab, auf den sich der Durchsatzvergleich mit dem H200 stützt.
- Vor der Medienveranstaltung im Oktober: Das Rack-Design IXL144 wurde auf der China International Industry Fair vorgestellt.
- 28. Oktober 2026: Iluvatar CoreX öffnete in Shanghai Live-Demonstrationen mit Tiangai-300-Hardware für die Medien.
Bei der Veranstaltung im Oktober ging es nicht mehr nur um Architekturvorstellungen, sondern um Systeme, auf denen konkrete Arbeitslasten ausgeführt wurden. Das vom Unternehmen beschriebene Einsatzspektrum reicht nun von einzelnen Beschleunigerkarten über Server mit acht Karten bis zum größeren System IXL144.
Ein Rack mit 144 GPUs
Das IXL144 vereint laut Iluvatar CoreX 144 GPUs und 18 CPUs in einem Standardrack und verfügt über rund 10,1 TB gemeinsamen GPU-Speicher. Das Unternehmen bezeichnete es als dichtesten GPU-Superknoten der Branche in einem einzelnen Rack. Ein Superknoten verbindet zahlreiche Prozessoren eng miteinander, damit sie gemeinsam umfangreiche Aufgaben bearbeiten können.
Die angegebene Speicherkapazität von 144 GB pro Tiangai 300 und die Gesamtkapazität von 10,1 TB für das Rack müssen genauer aufgeschlüsselt werden. 144 Karten mit jeweils 144 GB ergeben 20.736 GB, wobei Unterschiede bei der Berechnung der Kapazität noch nicht berücksichtigt sind. Aus der Beschreibung des Racks muss hervorgehen, wie die Karten konfiguriert sind und welche Speicherkapazität den Arbeitslasten zur Verfügung steht.
Iluvatar CoreX schätzt, dass das System die Kosten pro einer Million effektiver Token gegenüber gängigen internationalen Systemen um etwa 40 Prozent senken kann. Effektive Token bezeichnen Ausgaben, die als nutzbare Arbeit gewertet werden. Für Betreiber, die KI-Dienste anbieten, stellt dieser Wert die Hardwarekosten der Menge an nutzbarer Ausgabe gegenüber.
Eine Senkung um 40 Prozent würde bedeuten, dass eine Aufgabe, die auf dem Referenzsystem 100 Einheiten kostet, nur noch 60 Einheiten kosten würde. Die tatsächliche Ersparnis hängt vom Gerätepreis, dem Stromverbrauch, der Software, der Arbeitslast und davon ab, wie gleichmäßig die GPUs ausgelastet sind.
Das Unternehmen nannte außerdem ein Ziel für seinen Peer-to-Peer-Verbindungsbaustein der nächsten Generation: Eine einzelne Übertragung innerhalb des verbundenen Bereichs soll statt 3 bis 5 Mikrosekunden nur noch 1 Mikrosekunde dauern. Schnellere Kommunikation hilft, wenn verschiedene GPUs unterschiedliche Teile eines Modells berechnen und wiederholt Daten austauschen müssen.
KI-Arbeit auf verschiedene Chips verteilen
Iluvatar CoreX' Ansatz für den heterogenen Einsatz verteilt verschiedene Inferenzaufgaben auf unterschiedliche Prozessortypen. Bei der AFD-Trennung des Unternehmens übernimmt der Tiangai 300 die gesamte Prefill-Phase sowie die Attention-Berechnungen während des Decodings. Die Feed-forward-Expertennetzwerke werden von einem XPU eines Partners ausgeführt.
XPU ist eine allgemeine Bezeichnung für eine andere Art von Rechenbeschleuniger. Dahinter steht die Idee, jedem Prozessor die Aufgaben zuzuweisen, für die er sich am besten eignet, und den gesamten Ablauf von einem gemeinsamen Scheduler koordinieren zu lassen. Feed-forward-Netzwerke übernehmen einen weiteren großen Teil der mathematischen Verarbeitung in einem Sprachmodell.
Bei einheitlicher Planung meldete das Unternehmen eine um 60 Prozent geringere Inferenzlatenz beim Decoding. Diese Systemkonfiguration unterscheidet sich vom viel beachteten Durchsatzvorsprung von 5 Prozent gegenüber dem H200; auch die gemessene Leistungsgröße ist eine andere.
Shan Tianyi, Leiter für KI und beschleunigtes Rechnen bei dem Unternehmen, sagte, künftige KI-Rechensysteme würden davon abhängen, verschiedene Chips effizient zu organisieren, statt für jede Aufgabe auf einen einzigen Prozessortyp zu setzen. Die AFD-Demonstration zeigt diese Strategie in einer konkreten Konfiguration aus GPUs und Beschleunigern eines Partners.
Software soll die Bereitstellungszeit verkürzen
Iluvatar CoreX stellte außerdem einen Software-Stack nach dem Prinzip „KI für KI“ vor, der Teile der Bereitstellung und Optimierung automatisieren soll. Nach Angaben des Unternehmens sank die Zeit für die Einrichtung einer Umgebung von einer Stunde auf zehn Minuten; die Zahl manueller Arbeitsschritte ging von mehreren Dutzend auf einen zurück.
Bei einer Optimierungsaufgabe für ein großes Modell will das Unternehmen den Arbeitszyklus von sieben Tagen auf weniger als zwei Stunden verkürzt haben. Zugleich habe sich die Leistung dem Doppelten des vorherigen Werts angenähert. Diese Beispiele betreffen den Entwicklungsaufwand, der nötig ist, um Modelle effizient auf der Hardware auszuführen.
Das Unternehmen behauptete außerdem eine tiefe Integration mit FlyDSL, einer Sprache zur Entwicklung von GPU-Berechnungsroutinen. Die Kompilierung sei dadurch um mehr als 90 Prozent schneller geworden. Ein Arbeitsablauf, für den zuvor zehn Personen einen Tag gebraucht hätten, sei nun von einer Person in wenigen Stunden zu erledigen.
Softwareunterstützung ist wichtig, denn ein Prozessor braucht mehr als leistungsfähige Rechenhardware. Modelle, mathematische Bibliotheken und Bereitstellungswerkzeuge müssen zusammenspielen. Die Softwaredemonstrationen sollen zeigen, wie viel Entwicklungsaufwand Kunden betreiben müssen, bevor sie mit einer neuen GPU einen funktionierenden Dienst anbieten können.
TY1200 erweitert das Angebot auf Robotik
Bei der Veranstaltung in Shanghai wurde auch der Tongyang TY1200 vorgestellt, ein separater Prozessor für KI-PCs und physische KI, etwa für Roboter, die ihre Umgebung wahrnehmen und in der realen Welt handeln. Die angegebene Rechenleistung bei dichten Berechnungen beträgt 300 TOPS, also 300 Billionen Operationen pro Sekunde. Bei dieser Kennzahl werden Berechnungen gezählt, ohne ausgelassene Rechenoperationen mit Nullwerten einzubeziehen.
Iluvatar CoreX zufolge erreichte der TY1200 in Tests mit Qwen3.8-27B und Qwen3.6-35B-A3B das 1,2-Fache der Leistung des Nvidia Thor T5000. Bei den Modellen Cosmos-R2-2B und Cosmos-R2-8B in Anwendungen der physischen KI meldete das Unternehmen eine Leistung von 158 beziehungsweise 180 Prozent des Thor-T5000-Referenzwerts.
Der TY1200 kann dem Unternehmen zufolge außerdem GPU-beschleunigte Physiksimulationen mit MuJoCo-Warp ausführen. Damit kann ein Roboterentwicklungssystem Bewegungen simulieren, eine Steuerungsstrategie trainieren und Aktionen lokal überprüfen. Eine Steuerungsstrategie besteht aus den erlernten Anweisungen, nach denen ein Roboter seine Bewegungen ausrichtet.
Zu den genannten Anwendungen gehören Roboter, die Menschen bei Arztbesuchen unterstützen, industrielle Bildverarbeitung und die Besucherführung. Für den geplanten Nachfolger TY2000 wird eine Rechenleistung von 600T angegeben. Gemeinsam erweitern diese Produkte die Strategie des Unternehmens von großen KI-Servern auf Geräte, die in der Nähe von Nutzern und Maschinen arbeiten.
Die wichtigsten Punkte
- Iluvatar CoreX führte die Tiangai-300-Hardware am 28. Oktober 2026 in Shanghai vor.
- Das Unternehmen verwies auf Tests der Shanghai Electric Group, denen zufolge der Durchsatz pro Karte dem 1,05-Fachen der Nvidia-H200-Leistung entsprach.
- Eine Trainingsdemonstration mit Qwen3-32B auf acht GPUs soll bei FP8-Präzision pro Karte einen H100-Durchsatz in Höhe des 1,33-Fachen erreicht haben.
- Die detaillierte Methode hinter dem viel beachteten Benchmark eines Drittanbieters wurde nicht veröffentlicht.
- Das Rack IXL144 enthält 144 GPUs und 18 CPUs. Die Kosten pro einer Million effektiver Token sollen um 40 Prozent sinken.
- Bei einer separaten Bereitstellung, die Arbeit zwischen GPUs und XPUs aufteilte, soll sich die Latenz beim Decoding um 60 Prozent verringert haben.
- Bei der Veranstaltung ging es außerdem um Softwareautomatisierung sowie um Anwendungen des TY1200 für lokale KI und Robotersimulationen.