Ein Modell, das RNA-Bausteine und ihre Verbindungen lernt
Forschende der University of Science and Technology of China haben structRFM veröffentlicht, ein offenes RNA-Basismodell, das mit 21 Millionen Paaren aus RNA-Sequenzen und rechnergestützt annotierten Strukturen trainiert wurde. Die Veröffentlichung umfasst die gepaarten Trainingsdaten, die Modellgewichte und den Quellcode. Damit erhalten andere Labore die Materialien, um die Arbeit nachzuvollziehen und das System anzupassen.
Inhalt
- Ein Modell, das RNA-Bausteine und ihre Verbindungen lernt
- Warum die Faltung ebenso wichtig ist wie die Sequenz
- Wie 21 Millionen Trainingspaare zusammengestellt wurden
- Das Modell mit verborgenen Informationen trainieren
- Was die Strukturtests ergaben
- Von der RNA-Verarbeitung bis zur funktionellen Klassifizierung
- Was die offene Veröffentlichung Forschenden bietet
- Das Team und der Zeitplan der Veröffentlichung
- Was die Ergebnisse für die RNA-Forschung verändern
- Wichtige Punkte
Die am 4. November 2026 von Nature veröffentlichte Studie beschreibt ein Modell, das sowohl die Reihenfolge der molekularen Bausteine der RNA als auch die Verbindungen lernt, die zur Faltung dieser Moleküle beitragen. Die für die Vorhersage dreidimensionaler Strukturen entwickelte Anpassung namens Zfold erzielte den Autoren zufolge bei den Auswertungen CASP15-natural, CASP16 und RNA-Puzzles eine mit AlphaFold3 vergleichbare Leistung.
Der praktische Vorteil: Nach dem Training benötigt structRFM lediglich eine RNA-Sequenz als Eingabe. Das Modell liefert Informationen, die Forschende für verschiedene Aufgaben nutzen können, darunter die Vorhersage molekularer Strukturen, die Identifizierung von Stellen, die an der RNA-Verarbeitung beteiligt sind, und die funktionelle Klassifizierung von RNA-Molekülen.
Der Forschungsartikel zu structRFM in Nature stellt die Arbeit als Möglichkeit vor, Strukturwissen für verschiedene Vorhersageaufgaben nutzbar zu machen. Peng Xiong und S. Kevin Zhou sind die korrespondierenden Autoren, Heqin Zhu ist Erstautor.
Warum die Faltung ebenso wichtig ist wie die Sequenz
RNA ist an der Proteinproduktion, der Genregulation und der Verarbeitung genetischer Botschaften beteiligt. Ihre Sequenz bezeichnet die Reihenfolge ihrer Nukleotide, also der molekularen Einheiten, die meist mit den Buchstaben A, U, C und G dargestellt werden. Diese Reihenfolge trägt Informationen; zugleich beeinflusst die Faltung des Moleküls seine Funktion.
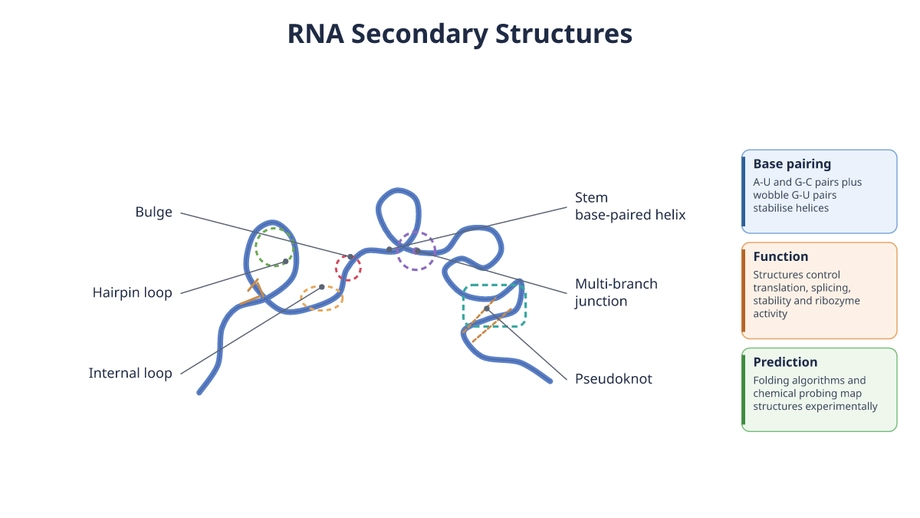
Abschnitte eines RNA-Strangs können sich mit anderen Abschnitten desselben Strangs verbinden. Diese Verbindungen bilden die Sekundärstruktur: ein Muster aus gepaarten Bereichen, Stämmen und Schleifen. Anschließend faltet sich das Molekül zu einer dreidimensionalen Form, der sogenannten Tertiärstruktur, die seine Aktivität und seine Wechselwirkungen mit anderen Molekülen beeinflusst.
Viele RNA-Sprachmodelle lernen Muster aus großen Sequenzsammlungen, ähnlich wie ein Sprachmodell Beziehungen zwischen Wörtern erfasst. structRFM bezieht beim Training zusätzlich Informationen darüber ein, welche Nukleotide sich miteinander paaren. So lernt es Verbindungen zwischen Positionen, die entlang der Sequenz weit auseinanderliegen können.
Die Forschenden wollten die Flexibilität eines Basismodells erhalten: eines breit trainierten Systems, dessen gelernte Merkmale sich für verschiedene Zwecke anpassen lassen. Ihr Ziel war es, Faltungsinformationen in dieses gemeinsame Modell einzubeziehen, statt ein System zu trainieren, das nur für eine einzelne Strukturaufgabe geeignet ist.
Wie 21 Millionen Trainingspaare zusammengestellt wurden
Das Team erstellte einen Datensatz mit rund 21 Millionen Paaren aus RNA-Sequenzen und Sekundärstrukturen. Die Strukturannotationen wurden rechnergestützt erzeugt. So konnten die Forschenden in einem deutlich größeren Maßstab trainieren als mit einer Sammlung, die ausschließlich aus durch Laborexperimente ermittelten Strukturen besteht.
Computergestützte Vorhersagen können Fehler enthalten und die Stärken und Schwächen des verwendeten Verfahrens widerspiegeln. Um die Abhängigkeit von einem einzelnen Vorhersagemodell zu verringern, entwickelten die Forschenden MUSES, ein Ensemble aus mehreren Quellen für Sekundärstrukturen. Ein Ensemble vereint Informationen aus mehreren Vorhersagequellen, statt sich vollständig auf eine einzige zu stützen.
MUSES setzt bei einem zentralen Problem des Trainings mit vorhergesagten Strukturen an: Wiederkehrende Fehler in den Trainingsannotationen können beeinflussen, was das Modell lernt. Durch die Kombination von Strukturvorhersagen sollten Verzerrungen einzelner Vorhersagemodelle verringert und zugleich nützliche Informationen über Basenpaarungen erhalten bleiben.
Für Training und Auswertung greift die Studie auf etablierte biologische Sammlungen zurück, darunter RNAcentral, Rfam und die Protein Data Bank. In der Datenbeschreibung werden die verwendeten Versionen aufgeführt, darunter RNAcentral 24.0 sowie Rfam 14.10 und 15.0. So können Forschende die in den Experimenten verwendeten Datensätze nachvollziehen.
Das Modell mit verborgenen Informationen trainieren
structRFM nutzt Masked Language Modelling, eine Trainingsmethode, bei der Teile einer Eingabe verborgen werden. Das Modell lernt, die fehlenden Informationen aus dem umgebenden Kontext zu erschließen. Bei RNA bedeutet das, Beziehungen zwischen Nukleotiden statt zwischen Wörtern zu lernen.
Das Team bezog Basenpaarungen mithilfe einer Paarabgleich-Operation in diesen Prozess ein. Ein dynamisches Maskierungsverhältnis balanciert das strukturgestützte Training mit der Maskierung einzelner Nukleotidpositionen. Dadurch kann das Modell sowohl lokale Sequenzmuster als auch mit der Faltung verknüpfte Beziehungen lernen.
Das Modell liefert drei Arten von Merkmalen: Informationen über die Sequenz als Ganzes, Informationen zu jedem einzelnen Nukleotid und Informationen zu Nukleotidpaaren. Ein Merkmal ist eine numerische Repräsentation, die ein anderes Vorhersagesystem nutzen kann. Je nach Aufgabe lassen sich unterschiedliche Ebenen dieser Repräsentation heranziehen.
Die Forschenden führten außerdem Ablationsexperimente durch. Dabei werden Teile eines Modells entfernt oder verändert, um ihren Beitrag zu prüfen. Die Experimente stützten die Annahme, dass sowohl die strukturellen Informationen als auch die Maskierungsstrategie zu den berichteten Verbesserungen beitrugen. Das liefert Hinweise darauf, welche Designentscheidungen hinter structRFM stehen.
Was die Strukturtests ergaben
structRFM zeigte starke Leistungen bei der Zero-Shot-Homologieklassifikation. Homologie bezeichnet Verwandtschaft, die auf einen gemeinsamen evolutionären Ursprung zurückgeht. Bei einer Zero-Shot-Klassifikation wird geprüft, wie gut die gelernten Repräsentationen solche Beziehungen erkennen lassen, ohne das Modell eigens für die jeweilige Klassifikationsaufgabe zu trainieren.
Die Autoren berichten zudem von Verbesserungen bei der Vorhersage von Sekundärstrukturen und starken Ergebnissen bei neu veröffentlichten RNA-Familien. Eine RNA-Familie umfasst verwandte Moleküle mit gemeinsamen Sequenz- oder Strukturmerkmalen. Tests mit neu veröffentlichten Familien zeigen, wie gut das Modell über die aus etablierten Datensätzen bekannten Gruppen hinaus funktioniert.
Für die Vorhersage von Tertiärstrukturen entwickelte das Team Zfold, indem es die gelernten Merkmale von structRFM für ein Modell anpasste, das dreidimensionale Formen vorhersagt. Den Autoren zufolge verbesserten sich sowohl die vorhergesagten Formen als auch die daraus abgeleiteten Sekundärstrukturen.
Zfold wurde anhand von CASP15-natural, CASP16 und RNA-Puzzles ausgewertet. Diese Benchmark-Sammlungen dienen der Bewertung von Vorhersagen molekularer Strukturen. Für alle drei Auswertungen beschreibt die Studie die Leistung als vergleichbar mit AlphaFold3. Der Vergleich bezieht sich auf Zfolds Ergebnisse bei den genannten Benchmarks; structRFM liefert die zugrunde liegenden RNA-Repräsentationen.
Die Studie beschreibt mehrere Arten von Erfolg statt eines einzelnen Genauigkeitswerts für sämtliche Anwendungen. Verwandte Sequenzen zu erkennen, Basenpaare vorherzusagen und eine dreidimensionale Form zu rekonstruieren sind unterschiedliche Aufgaben, die jeweils eigene Auswertungen erfordern.
Von der RNA-Verarbeitung bis zur funktionellen Klassifizierung
structRFM wurde auch für Aufgaben getestet, bei denen es um die Funktion von RNA geht. Dazu gehörten die Vorhersage von Spleißstellen, die Identifizierung interner ribosomaler Eintrittsstellen und die Klassifizierung nichtkodierender RNA. Damit ging die Auswertung über die molekulare Form hinaus.
Spleißstellen markieren die Grenzen, an denen Zellen RNA-Botschaften verarbeiten. Beim Spleißen werden ausgewählte Abschnitte entfernt und die verbleibenden Teile miteinander verbunden. Die Vorhersage dieser Grenzen hilft Forschenden zu untersuchen, wie eine genetische Botschaft zusammengesetzt wird, bevor sie zur Herstellung eines Proteins dient.
Interne ribosomale Eintrittsstellen, auch IRES-Elemente genannt, sind RNA-Abschnitte, an denen die für die Proteinherstellung zuständige Zellmaschinerie die Translation intern beginnen kann. Ihre Identifizierung setzt voraus, funktionelle Muster innerhalb einer Sequenz zu erkennen. Damit wird auch geprüft, welche Informationen das Modell während des Vortrainings erfasst hat.
Nichtkodierende RNAs erfüllen Aufgaben, die über die Funktion als Vorlage für die Proteinproduktion hinausgehen. Bei ihrer Klassifizierung werden Moleküle relevanten Gruppen zugeordnet. Die Autoren berichten von besseren Ergebnissen bei diesen funktionellen Aufgaben. Das zeigt, dass die gelernten Repräsentationen auch dann nützlich blieben, wenn sich das Vorhersageziel von der Struktur auf die biologische Funktion verlagerte.
Das Team erweiterte das Modell außerdem mithilfe einer Segmentierungsstrategie auf die Klassifizierung langer nichtkodierender RNAs. Wird eine lange Sequenz in Abschnitte unterteilt, lässt sich das Modell auch auf Eingaben anwenden, die sich sonst nur schwer als Ganzes verarbeiten ließen.
Was die offene Veröffentlichung Forschenden bietet
Die Veröffentlichung umfasst drei Ressourcen mit unterschiedlichen Einsatzmöglichkeiten. Der Datensatz enthält die für das Training verwendeten Beispiele. Die Modellgewichte enthalten die beim Training erlernten numerischen Werte. Der Quellcode beschreibt, wie die Software umgesetzt ist und ausgeführt wird.
Mit den Gewichten können Forschende ein bereits trainiertes Modell nutzen, statt den gesamten Vortrainingsprozess zu wiederholen. Der Zugriff auf Daten und Code ermöglicht eine genauere Prüfung des Trainingsverfahrens, die Reproduktion von Experimenten und die Entwicklung alternativer Ansätze.
Der Artikel nennt das Projekt-Repository auf GitHub: heqin-zhu/structRFM. Außerdem führt er ein Zenodo-Archiv für den Vortrainingsdatensatz mit der DOI 10.5281/zenodo.18272040 sowie ein Archiv für den Quellcode und die Modell-Checkpoints mit der DOI 10.5281/zenodo.18274292 auf. Eine DOI ist ein dauerhafter Bezeichner, der eine Forschungsressource langfristig auffindbar machen soll.
Laut Datenbeschreibung sind die Trainings- und Testdatensätze über das Projekt-Repository öffentlich zugänglich. Außerdem stellt das Team die in der Studie verwendete aufbereitete IRES-Aufteilung und die den Abbildungen zugrunde liegenden Daten bereit. Die Autoren erklären, dass die Daten ohne Einschränkungen verfügbar sind.
Diese Angaben sind für Vergleiche wichtig. Forschende können nachvollziehen, welche Datensätze und Aufteilungen verwendet wurden, Auswertungen erneut durchführen und prüfen, ob eine andere Trainingsentscheidung die Ergebnisse verändert. Die Veröffentlichung ermöglicht somit nicht nur die Wiederverwendung des Modells, sondern auch eine kritische Prüfung der Ergebnisse.
Das Team und der Zeitplan der Veröffentlichung
Die Arbeit entstand an der School of Biomedical Engineering der USTC und im Labor Medical Imaging, Robotics, Analytic Computing and Learning, kurz MIRACLE. Die Autoren nennen Standorte in Hefei sowie am Suzhou Institute for Advanced Research der USTC. Mitautor Ruifeng Li ist dem College of Computer Science and Technology der Zhejiang University in Hangzhou zugeordnet.
Zhou, Professor, und Xiong, wissenschaftlicher Mitarbeiter mit besonderer Forschungsfunktion, entwickelten die Studie und betreuten sie. Zhu entwarf und implementierte das Framework, führte das Vortraining sowie mehrere Experimente zur Strukturvorhersage und RNA-Klassifizierung durch und analysierte die Ergebnisse. Weitere Teammitglieder arbeiteten an Homologietests, Datensatzvergleichen, der Identifizierung von IRES-Elementen und der Strukturauswertung.
Die Veröffentlichung und die öffentliche Vorstellung der Arbeit fallen auf zwei verschiedene Kalendertage:
- 4. November 2026: Nature führt die Veröffentlichung von An open structure-guided RNA foundation model for generalizable prediction auf.
- 5. November 2026: Die Arbeit und ihre offene Veröffentlichung wurden in China öffentlich bekannt gemacht; die Online-Veröffentlichung soll am frühen Morgen erschienen sein.
Nach Angaben der Autoren wurde die Arbeit durch die Nationale Stiftung für Naturwissenschaften Chinas, das Nationale Schlüsselprogramm für Forschung und Entwicklung, Forschungsprogramme in Jiangsu und Suzhou sowie das Sanming Project of Medicine in Shenzhen gefördert. Sie erklären, dass keine Interessenkonflikte bestehen.
Was die Ergebnisse für die RNA-Forschung verändern
structRFM bietet mehreren Forschungsbereichen eine gemeinsame Ausgangsbasis. Ein Labor, das RNA-Verarbeitung untersucht, kann dasselbe zugrunde liegende Modell anpassen, das eine andere Gruppe für die Faltungsforschung oder die Klassifizierung nichtkodierender Moleküle nutzt. Für jede Anwendung sind weiterhin eine eigene, aufgabenspezifische Entwicklung und Auswertung erforderlich.
Die Kombination aus 21 Millionen Trainingspaaren, strukturgestütztem Lernen und veröffentlichten Checkpoints bietet Forschenden ein konkretes System, das sie untersuchen können, statt lediglich eine Beschreibung eines Algorithmus. Auch MUSES und die Maskierungsexperimente liefern konkrete Designentscheidungen, die andere Teams prüfen oder verändern können.
Die berichteten Ergebnisse betreffen rechnergestützte Vorhersagen und Klassifizierungen. Für biomedizinische Anwendungen wären weitere biologische Experimente nötig, darunter die Überprüfung vorhergesagter Strukturen und Tests der Funktionen, die bestimmten RNA-Molekülen zugeschrieben werden.
Der Artikel nennt keinen Zeitplan für eine klinische Anwendung. Die unmittelbare Veränderung besteht im Zugang: Forschende weltweit können die Trainingsressourcen abrufen, die Implementierung prüfen und untersuchen, ob sich die berichteten Verbesserungen auf ihre eigenen RNA-Datensätze übertragen lassen.
Wichtige Punkte
- Forschende der USTC haben structRFM veröffentlicht, ein RNA-Basismodell, das mit rund 21 Millionen Paaren aus Sequenzen und Sekundärstrukturen trainiert wurde.
- Das Modell lernt Sequenzmuster und Basenpaarungen und erzeugt seine Merkmale anschließend allein aus der Sequenz.
- MUSES kombiniert Strukturvorhersagen aus mehreren Quellen; dynamisches Maskieren balanciert beim Training strukturelle und nukleotidbezogene Informationen.
- Die Autoren berichten von starken Ergebnissen bei der Homologieklassifikation und Verbesserungen bei der Vorhersage von Sekundärstrukturen, auch bei Tests mit neu veröffentlichten RNA-Familien.
- Zfold, die Anpassung für die Vorhersage von Tertiärstrukturen, erzielte bei drei genannten Benchmark-Sammlungen eine den Autoren zufolge mit AlphaFold3 vergleichbare Leistung.
- Datensatz, Modellgewichte, Quellcode und Auswertungsressourcen sind öffentlich zugänglich und können wiederverwendet werden, um Ergebnisse nachzuvollziehen.