Ein gemeinsames Fertigungskonzept für drei Speicheranbieter
Nvidia hat Samsung Electronics, SK hynix und Micron gebeten, für die Basisdies der nächsten Generation seines kundenspezifischen High-Bandwidth-Memorys (HBM) den 3-nm-Fertigungsprozess von TSMC zu verwenden. Das berichten Branchenkreise am 18. Oktober 2026. Berichten zufolge stimmte Samsungs Sparte Device Solutions nach einer internen Prüfung zu. Damit bezieht das Unternehmen seinen taiwanischen Foundry-Konkurrenten in einen Teil der Speicherfertigung ein, den Samsung traditionell selbst übernommen hat.
Inhalt
- Ein gemeinsames Fertigungskonzept für drei Speicheranbieter
- Was ändert sich im Speicherstapel?
- Warum Nvidia bei allen Anbietern denselben Prozess will
- Samsung behält die eigenen Werke im Blick
- Micron und SK hynix verfolgen unterschiedliche Wege
- Was Nvidias Leistungsangaben bedeuten
- Amazon verbindet Speicher mit Nvidias Plattform
- Wie sich die Entwicklung vollzog
- Die wichtigsten Punkte
Das Produkt mit dem Namen NVHBM basiert auf HBM4E, der siebten Generation von High-Bandwidth-Memory. Nvidia will außerdem, dass die Anbieter für die Speicherstapel die sechste Generation der DRAM-Fertigungstechnologie verwenden, die als 1c bezeichnet wird. Ziel ist es, Speicher verschiedener Anbieter einheitlicher funktionieren zu lassen und den technischen Aufwand für die Freigabe der Produkte jedes einzelnen Anbieters zu verringern.
Mit Samsungs Entscheidung würde sich die bestehende Zusammenarbeit mit TSMC von der Kompatibilität bei der Verpackung auf die HBM-Fertigung ausweiten. Vor vier Jahren arbeiteten die Unternehmen zusammen, um sicherzustellen, dass sich Samsung-Speicher über die Packaging-Technologie von TSMC mit Grafikprozessoren verbinden lässt. Die Fertigung eines wichtigen Chips innerhalb des Speicherstapels geht in dieser Zusammenarbeit noch einen Schritt weiter.
Nvidias Vorschlag verändert auch die Aufgabe des Basisdies. Bei NVHBM wird der Speichercontroller, also die Schaltung, die den Datenfluss steuert, vom Hauptprozessor an den unteren Rand des Speicherstapels verlagert. Damit wird der Basisdie zu einem wichtigeren Bestandteil des Computersystems und dient nicht mehr nur als Verbindung zwischen Speicher und Prozessor.
Für Samsung bedeutet die Zustimmung zu dieser Architektur, zwei Entscheidungen voneinander zu trennen, die das Unternehmen bisher gemeinsam getroffen hat: Wer den Speicher herstellt, in dem Informationen abgelegt werden, und wer den Logikchip fertigt, der dessen Verbindung zum Prozessor steuert. Samsung würde den Speicher weiterhin liefern, während TSMC den spezifizierten Basisdie herstellt.
Was ändert sich im Speicherstapel?
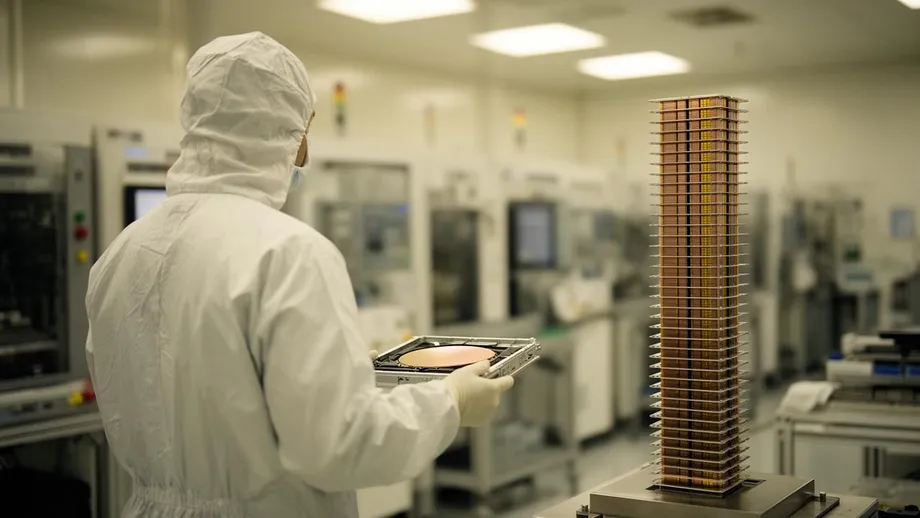
Bei HBM werden mehrere Speicher-Dies neben einem leistungsstarken Prozessor übereinandergestapelt. Durch diese Bauweise können große Datenmengen über kurze Distanzen übertragen werden. So lassen sich die Recheneinheiten von KI-Beschleunigern zuverlässig mit Daten versorgen. Ein Die ist ein einzelnes Stück Silizium mit elektronischen Schaltungen.
Die Core-Dies speichern Daten. Der Basisdie liegt darunter und übernimmt Verbindungen sowie Logikfunktionen. Bei einer herkömmlichen Anordnung befindet sich der Speichercontroller weiterhin auf dem Hauptdie des Beschleunigers. NVHBM verlagert diesen Controller in den Basisdie und schafft so auf dem Prozessor Platz für andere Schaltungen.
Nvidia verwendet außerdem eine eigene physikalische Schnittstelle, die als PHY bezeichnet wird, um die Chips zu verbinden. Die PHY ist die Schaltung, die elektrische Signale sendet und empfängt. Technische Beschreibungen von NVHBM zufolge ersetzt die Lösung die breite parallele Schnittstelle, die bei standardisiertem HBM üblich ist, durch eine schmalere proprietäre serielle Verbindung. Diese überträgt Daten über weniger Verbindungen mit höherer Geschwindigkeit.
Die Größe der herkömmlichen Schnittstelle erklärt, warum diese Lösung attraktiv ist. HBM4 verfügt über 32 Kanäle mit jeweils 64 Bit, also insgesamt 2.048 Bit. Die Verwaltung dieser Verbindungen erfordert beträchtliche Schaltungen und eine komplexe Verdrahtung zwischen den Chips. NVHBM soll diesen Aufwand verringern und das Routing auf dem Interposer vereinfachen, der Verbindungsschicht unter den Chips.
Nvidia bietet NVHBM über NVLink Fusion als Baustein für Partner an, die kundenspezifische Chips entwickeln. Standard-HBM bleibt eine separate Produktkategorie. Partner, die sich für NVHBM entscheiden, würden Nvidias spezifiziertes Controller- und Verbindungskonzept in ihre eigenen Beschleunigersysteme integrieren.
Warum Nvidia bei allen Anbietern denselben Prozess will
Nvidias vorgeschlagenes Fertigungskonzept kombiniert TSMCs 3-nm-Logikprozess mit fortschrittlichen DRAM-Prozessen für die Speicherschichten. Logik und DRAM erfüllen unterschiedliche Aufgaben und werden mit unterschiedlichen Verfahren hergestellt. Die Bezeichnung 3 nm steht für eine Generation der Logikfertigung, während 1c eine Generation der DRAM-Technologie bezeichnet.
Samsung, SK hynix und Micron haben jeweils eigene Designs und Fertigungsmethoden. Diese Unterschiede können zusätzliche Tests erforderlich machen, wenn ein Entwickler von Beschleunigern Speicher von mehreren Unternehmen beziehen will. Ein einheitlicher Fertigungsprozess für den Basisdie bietet Entwicklern einen konsistenteren Ausgangspunkt.
Bei der Validierung wird geprüft, ob Prozessor, Speicher und Packaging zusammen mit der vorgesehenen Geschwindigkeit, Leistungsaufnahme und Zuverlässigkeit funktionieren. Diese Arbeit für unterschiedliche Implementierungen zu wiederholen, kostet Entwicklungszeit. Mit Nvidias Vorschlag soll der separate Integrationsaufwand sinken, der beim Wechsel des Speicheranbieters anfällt.
Micron bezeichnet seine kommende DRAM-Generation als 1-gamma. Sie ist weitgehend mit der 1c-Generation vergleichbar, wie sie in der Terminologie von Samsung und SK hynix genannt wird. Ein gemeinsames Ziel führt somit Fertigungsgenerationen mit unterschiedlichen Unternehmensbezeichnungen zusammen, ohne die Speicherprozesse aller Anbieter identisch zu machen.
TSMC würde zum gemeinsamen Fertigungspartner für Speicherprodukte konkurrierender Anbieter. Das könnte die Umsetzung bei Nvidia über mehrere Anbieter hinweg vereinfachen und zugleich einen wichtigen Fertigungsschritt bei einer Foundry konzentrieren. Samsungs Prüfung einer alternativen Fertigungsroute zeigt, wie wichtig es ist, ausreichend Basisdies zu sichern.
Samsung behält die eigenen Werke im Blick
Samsung will sein integriertes Fertigungsmodell für Standard-HBM beibehalten. Die HBM4- und HBM4E-Produkte des Unternehmens nutzen Samsungs eigenen 4-nm-Prozess für den Basisdie und den 1c-Prozess für die Core-Dies. Die Speicherschichten werden an den südkoreanischen Standorten Hwaseong und Pyeongtaek gefertigt.
Samsung nahm die Massenproduktion von HBM4 Anfang 2026 auf. Zum Zeitpunkt des Berichts im Oktober wurde HBM4E für die Massenproduktion qualifiziert. Bei der Qualifizierung wird geprüft, ob ein Produkt die Voraussetzungen erfüllt, um kontinuierlich nach dem geforderten Standard gefertigt zu werden.
Auch kundenspezifisches HBM für andere Kunden, darunter AMD, soll Samsungs integriertem Ansatz folgen. Die Entscheidung zu NVHBM bezieht sich daher konkret auf Nvidias Anforderungen und bedeutet nicht, dass Samsung künftig grundsätzlich keine Basisdies mehr selbst herstellt.
Es wird erwartet, dass Samsungs Memory Business die Design- und Optimierungsunterstützung für die von TSMC gefertigten Basisdies übernimmt. Damit würde sich die Aufgabenverteilung innerhalb von Samsung ändern, wo System LSI und die Foundry-Sparte traditionell an intern gefertigten Basisdies mitgewirkt haben.
Samsung prüft außerdem, ob die eigene Foundry NVHBM-Basisdies herstellen könnte, falls die Nachfrage die Kapazität von TSMC übersteigt. Diese Ausweichmöglichkeit würde eine weitere Fertigungsoption sichern, auch wenn die von Nvidia gemeldete Spezifikation derzeit auf TSMCs 3-nm-Prozess beruht.
Micron und SK hynix verfolgen unterschiedliche Wege
Microns Umstellung geht über Nvidias kundenspezifisches Produkt hinaus. Das Unternehmen teilt mit, dass sowohl NVHBM, das gemeinsam mit Nvidia entwickelt wurde, als auch sein Standard-HBM4E Basisdies eines externen Auftragsfertigers verwenden werden. Diese Fertigung soll voraussichtlich TSMC übernehmen.
Bei HBM4 kombiniert Micron Speicher-Dies aus dem eigenen 1-beta-Prozess mit einem intern gefertigten Basisdie. Bei HBM4E werden die Speicherschichten auf 1-gamma umgestellt und die Basisdies außerhalb von Microns eigenen Werken gefertigt. Micron verändert damit beide wesentlichen Teile des Stapels: Das Unternehmen nutzt einen neueren Speicherprozess und setzt zugleich auf einen externen Partner für die Logikfertigung.
Microns Chief Operating Officer Manish Bhatia erwartet bei NVHBM höhere durchschnittliche Verkaufspreise und bessere Margen. Seine Begründung: HBM wird bereits mit einem Aufpreis verkauft, und der zusätzliche Aufwand sowie die Funktionen der kundenspezifischen Anpassung schaffen weiteren Mehrwert. Die Auslagerung des Basisdies kann somit mit der Erwartung höherer Profitabilität einhergehen.
SK hynix nutzt für die Basisdies von HBM4 bereits TSMCs 12-nm-Logikprozess. Branchenkreisen zufolge wird TSMCs 3-nm-Prozess für HBM4E und künftiges kundenspezifisches HBM priorisiert. Damit käme eine fortschrittlichere Logikfertigung bei einer Komponente zum Einsatz, die zusätzliche Aufgaben übernimmt.
SK hynix präsentierte Anfang des Jahres bei Nvidias GTC außerdem ein Konzept für kundenspezifisches HBM auf Basis seiner Stream-DQ-Technologie. Im Mittelpunkt steht dabei, Daten kontinuierlich zu verwalten und Prozessoren zuzuführen. Bei allen drei Anbietern geht der Trend dahin, dem Basisdie eine aktivere Rolle bei der Datenübertragung zu geben.
Was Nvidias Leistungsangaben bedeuten
Nvidia zufolge kann NVHBM pro Stapel bis zu 30 Prozent mehr Bandbreite als Standard-HBM4E bieten und den HBM-Stromverbrauch um 15 Prozent senken. Die Bandbreite gibt an, wie viele Daten in einem bestimmten Zeitraum übertragen werden können. Eine höhere Bandbreite kann einem KI-Prozessor helfen, der auf Informationen aus dem Speicher wartet.
Ein vereinfachter Vergleich: Liefert ein Standard-HBM4E-Stapel in einem bestimmten Zeitraum 100 Dateneinheiten, würde Nvidias maximal angegebene Verbesserung den Wert auf 130 erhöhen. Verbraucht der Vergleichsspeicher 100 Leistungseinheiten, würde die angegebene Senkung den HBM-Verbrauch auf 85 Einheiten reduzieren. Diese Beispiele veranschaulichen die Prozentangaben und beziehen sich nicht auf bestimmte ausgelieferte Produkte.
Nvidia spricht außerdem davon, bis zu 25 Prozent der Fläche des XPU-Rechendies freizugeben. XPU ist ein Oberbegriff für einen Rechenprozessor, zu dem auch kundenspezifische KI-Beschleuniger zählen. Wenn die Speicherschaltungen verlagert werden, können Entwickler mehr Siliziumfläche für Rechenfunktionen vorsehen.
Ein weiterer Bericht zu Nvidias Präsentation nennt bis zu 30 Prozent mehr Rechenleistung auf dem Hauptdie. Diese Angabe bezieht sich auf mögliche Rechenressourcen, während die 25-Prozent-Angabe die durch die Architekturänderung frei werdende Siliziumfläche beschreibt. Wie der gewonnene Platz genutzt wird, müssen die Entwickler weiterhin selbst entscheiden.
Die kundenspezifische PHY soll die von der Schnittstelle belegte Fläche um bis zu 67 Prozent verringern. Eine technische Einschätzung leitet diesen Wert aus der geringeren Zahl an Pins ab. Nvidias umfassendere Vergleiche zu Bandbreite, Stromverbrauch und Fläche beziehen sich auf Standard-HBM4E, obwohl diese Generation noch nicht ausgeliefert wurde.
Bei einem KI-Dienst kann eine schnellere Datenübertragung Antworten beschleunigen, wenn der Speicher der begrenzende Faktor ist. Ein geringerer Speicherstromverbrauch kann Systementwicklern mehr Spielraum innerhalb eines Strombudgets geben. Die Auswirkungen auf einen vollständigen Server hängen neben dem Speicher auch vom Prozessor, der Arbeitslast, der Vernetzung und der Kühlung ab.
Amazon verbindet Speicher mit Nvidias Plattform
Amazon Annapurna Labs ist der erste angekündigte NVHBM-Partner. Das Chipdesign-Unternehmen entwickelt Trainium-Beschleuniger für Amazon Web Services. Damit kann Nvidia Speichertechnologie an ein Unternehmen liefern, das auch eigene KI-Prozessoren entwickelt.
Nafea Bshara, Vizepräsident bei Annapurna Labs, beschrieb den Zweck der Partnerschaft in Kommentaren zur Ankündigung:
Wir freuen uns auf diese technologische Zusammenarbeit, von der künftige AWS-Infrastrukturlösungen profitieren werden.
Trainium 4 von Annapurna soll NVLink Fusion unterstützen. Berichten zur Einführung von NVHBM zufolge soll die Technologie entweder mit Trainium 4 oder mit einer späteren Generation auf den Markt kommen. Welche Chipgeneration genau zum Einsatz kommt und wann Amazons NVHBM-Implementierung kommerziell verfügbar sein wird, ist öffentlich noch nicht geklärt.
NVLink Fusion bietet Partnern Zugang zu Technologien wie NVLink Chiplet, NVLink-C2C, NVLink Switch sowie MGX-Systemen und -Racks. Diese ermöglichen Verbindungen und Systemdesigns, um kundenspezifische Prozessoren in Nvidias Recheninfrastruktur einzubinden. NVHBM ergänzt dieses Angebot um das Speichersubsystem.
Berichten zufolge entschied sich MediaTek fünf Tage nach der NVHBM-Ankündigung für NVLink Fusion und plante, die Technologie eigenen XPU-Kunden anzubieten. Damit erhält Nvidia einen weiteren Zugang zu Projekten mit kundenspezifischen Beschleunigern, einem Markt, in dem auch Broadcom und Marvell konkurrieren. Marvell hatte im Dezember 2024 einen vergleichbaren Ansatz zur Verlagerung der Speichersteuerung beschrieben. Die Akzeptanz bei Kunden und die Integration in Systeme sind daher wichtige Wettbewerbsfaktoren.
Wie sich die Entwicklung vollzog
Bei der Entwicklung von NVHBM kamen Veränderungen an der Architektur, den Beziehungen zu Lieferanten und der Akzeptanz bei Kunden zusammen. Der zeitliche Ablauf verdeutlicht, warum Samsungs Entscheidung im Oktober wichtig ist: Nvidia stellte zunächst das gemeinsame Design vor, anschließend mussten die Speicherhersteller entscheiden, wie sie es fertigen würden.
- Dezember 2024: Marvell beschrieb ein vergleichbares Konzept mit einer anderen Anordnung der Speichersteuerungsfunktionen.
- Anfang 2026: Samsung nahm die Massenproduktion von HBM4 auf, während SK hynix sein Konzept für kundenspezifisches HBM auf Basis von Stream DQ bei der GTC präsentierte.
- 26. August 2026: Nvidia kündigte NVHBM als Ergänzung zu NVLink Fusion an und nannte Annapurna Labs als ersten Partner.
- Fünf Tage später: MediaTek entschied sich Berichten zufolge für NVLink Fusion und plante, die Technologie seinen XPU-Kunden anzubieten.
- 18. Oktober 2026: Branchenkreise berichteten von Nvidias Forderung nach Basisdies in TSMCs 3-nm-Technik und von Samsungs Zustimmung nach einer internen Prüfung.
Samsungs Entscheidung bringt den Fertigungsplan Nvidias Ziel einer einheitlichen Implementierung bei mehreren Speicheranbietern näher. Zugleich hält Samsung mit seinen eigenen Investitionen in Basisdies an einer anderen Fertigungsroute für Standard-HBM und kundenspezifische Produkte für andere Kunden fest.
Die wichtigsten Punkte
- Nvidia will Berichten zufolge, dass Samsung, SK hynix und Micron für die NVHBM-Basisdies TSMCs 3-nm-Prozess verwenden.
- Bei NVHBM wird der Speichercontroller vom Hauptprozessor in den Basisdie des HBM-Stapels verlagert.
- Samsung stimmte der Anfrage zu, will aber die interne Fertigung für Standard-HBM und andere kundenspezifische Produkte beibehalten.
- Micron plant, die Basisdies sowohl für NVHBM als auch für Standard-HBM4E extern fertigen zu lassen; SK hynix arbeitet bereits bei HBM4 mit TSMC zusammen.
- Nvidia gibt im Vergleich zu Standard-HBM4E bis zu 30 Prozent mehr Bandbreite und einen um 15 Prozent niedrigeren HBM-Stromverbrauch an.
- Amazon Annapurna Labs ist der erste angekündigte Partner. Samsung prüft zugleich die eigene Foundry als mögliche Ausweichlösung für die Fertigung.