Ein Coding-Upgrade kommt mit einem öffentlichen Suchdienst
DeepSeek hat am 17. Oktober 2026 V4.1-Flash-1017 veröffentlicht und dabei Website, App und API gleichzeitig aktualisiert. Zudem stellte das Unternehmen zwei Dienste bereit, mit denen Entwickler im Web suchen und einzelne Seiten abrufen können. DeepSeek gibt für jeden Search- und Fetch-Endpunkt einen Preis von 0,75 US-Dollar je 1.000 Aufrufe an. Berechtigte Aufrufe über Server-Tools werden ab dem 31. Oktober um 16:00 Uhr UTC abgerechnet, also ab dem 1. November um Mitternacht in Peking.
Inhalt
- Ein Coding-Upgrade kommt mit einem öffentlichen Suchdienst
- Was wunschgesteuertes Programmieren in der Praxis bedeutet
- Wo die Benchmark-Werte am stärksten steigen
- Warum kürzere Antworten die Aufgabenkosten senken können
- Search findet Seiten, Fetch ruft sie ab
- Was Entwickler zahlen und ab wann
- Harness-Updates verbinden das Modell mit dem Arbeitsalltag
- Offene Gewichte und Bereitstellungsoptionen
- Die Termine für die Einführung
- Wichtige Punkte
Die Veröffentlichung erfolgt 37 Tage nach dem ersten Erscheinen von V4.1 Flash am 10. September. Entwickler können den Modellnamen deepseek-flash weiterhin verwenden; auch die bestehende Aufrufmethode und die Preise der Modell-API bleiben unverändert. DeepSeek stellt das aktualisierte Modell zudem offen über Hugging Face und ModelScope bereit.
In der offiziellen Veröffentlichungsmitteilung von DeepSeek steht die Entwicklung vollständiger Projekte im Mittelpunkt. Zu den Beispielen gehören ein Modell der Verbotenen Stadt in Peking, ein browserbasiertes Rennspiel, eine mit der Engine Godot erstellte Neuauflage von Portal 2 sowie eine bewegte 3D-Szene, die die Geschichte von der Urzeit bis in die Moderne nachzeichnet.
DeepSeek zufolge arbeitet das Modell besser, benötigt weniger Zeit und erzeugt kürzere Ausgaben. Für Entwickler betreffen diese Änderungen gleich zwei Kostenfaktoren: die Zeit, in der eine automatisierte Aufgabe einen Computer beansprucht, und die Menge des generierten Textes, die der Modelldienst abrechnet.
Mit dem Start der Suche kommt ein weiterer Baustein für diesen Arbeitsablauf hinzu. Eine KI-Anwendung kann nun DeepSeeks Modell zur Aufgabenplanung, die Suchmaschine zum Finden aktueller Informationen und den Fetch-Dienst zum Abrufen einer ausgewählten Webseite nutzen.
Was wunschgesteuertes Programmieren in der Praxis bedeutet
DeepSeek beschreibt das zentrale Ziel des Projekts als Programmieren nach den Wünschen der Nutzer: Jemand erklärt in Alltagssprache, was er möchte, und die KI übernimmt mehr von der Arbeit, die nötig ist, um daraus ein funktionierendes Projekt zu machen.
Die vier Demonstrationen umfassen unterschiedliche Arten von Arbeit. Beim Beispiel zur Verbotenen Stadt steht die 3D-Modellierung im Mittelpunkt. Das Rennspiel erfordert Interaktion im Browser. Für die Neuauflage von Portal 2 kommt die bestehende Spiele-Engine Godot zum Einsatz. Valley of Ages zeigt sich wandelnde Umgebungen über einen langen Abschnitt der Menschheitsgeschichte hinweg.
DeepSeek zufolge wurden diese Projekte mit relativ wenigen Eingaben, begrenztem Referenzmaterial und wenigen Interaktionsrunden in DeepSeek Harness erstellt. Das Unternehmen führt die Verbesserungen auf Reinforcement Learning mit Selbst-Feedback zurück. Bei dieser Trainingsmethode helfen Rückmeldungen zu bisherigen Arbeitsversuchen dabei, das spätere Verhalten zu formen.
Ein Harness ist die Software rund um ein Sprachmodell, die Werkzeuge, Dateien, Sitzungen und die Ausführung von Aufgaben verwaltet. Das Modell kann Code vorschlagen oder entscheiden, was als Nächstes zu tun ist; das Harness stellt die Umgebung bereit, in der diese Aktionen stattfinden. Damit ist die umgebende Software neben dem Modell selbst Teil des Entwicklungsprozesses.
Wo die Benchmark-Werte am stärksten steigen
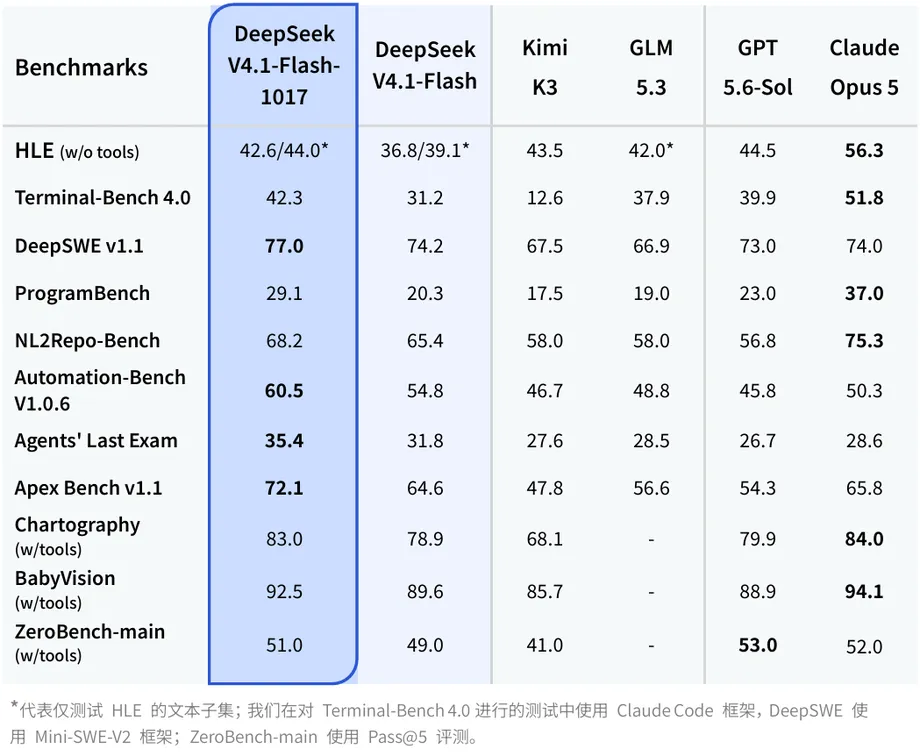
In den veröffentlichten Tests erreicht das aktualisierte Modell von DeepSeek bei DeepSWE v1.1 einen Wert von 77,0. Die September-Version kam auf 74,2. Das entspricht einem Plus von 2,8 Punkten in einer Bewertung von Softwareentwicklungsaufgaben. Im Vergleich des Unternehmens erzielte Claude Opus 5 einen Wert von 74,0 und GPT 5.6-Sol einen Wert von 73,0.
Bei Terminal-Bench 4.0 ist der Anstieg gegenüber der vorherigen Flash-Version größer: Der Wert stieg von 31,2 auf 42,3, ein Plus von 11,1 Punkten. ProgramBench verbesserte sich von 20,3 auf 29,1, NL2Repo-Bench von 65,4 auf 68,2.
DeepSeek führt auch Verbesserungen bei Aufgaben mit Agenten an, also Systemen, die Werkzeuge einsetzen, um eine Abfolge von Aktionen auszuführen. Automation-Bench v1.0.6 stieg von 54,8 auf 60,5, Agents' Last Exam von 31,8 auf 35,4 und Apex Bench v1.1 von 64,6 auf 72,1.
In DeepSeeks Vergleichstabelle liegt das aktualisierte Modell bei DeepSWE, Automation-Bench, Agents' Last Exam und Apex Bench vor den aufgeführten Modellen von Anthropic, OpenAI, Kimi und Zhipu. Bei mehreren anderen Tests, darunter Terminal-Bench, ProgramBench und NL2Repo, erzielt Claude Opus 5 höhere Werte.
Die Testbedingungen sind für die Einordnung dieser Zahlen wichtig. DeepSeek gibt für Terminal-Bench 4.0 einen Wert von 42,3 an, während eine Bewertung von Artificial Analysis bei 26,8 liegt. Die detaillierten Einstellungen, die diese Abweichung erklären könnten, werden nicht genannt. DeepSeek nennt Claude Code als Umgebung für Terminal-Bench und Mini-SWE-V2 für DeepSWE. Das zeigt, dass Modell und umgebende Werkzeuge gemeinsam bewertet werden.
Warum kürzere Antworten die Aufgabenkosten senken können
DeepSeek bezeichnet das Update als Pareto-Verbesserung bei Leistung und Kosten. Einfach gesagt lautet die Behauptung: Nutzer erhalten bessere Ergebnisse und geben zugleich weniger aus, statt für höhere Qualität eine größere Rechnung in Kauf nehmen zu müssen.
Modelldienste rechnen üblicherweise nach Token ab, den kleinen Einheiten, in die Text für die Verarbeitung zerlegt wird. Eine kürzere generierte Antwort benötigt weniger Ausgabetoken. Ein Coding-Agent kann während eines einzelnen Auftrags viele Antworten erzeugen. Weniger unnötige Ausgaben in diesen Schritten können daher die Gesamtkosten senken.
DeepSeek zufolge verkürzen sich auch die Ausführungszeiten von Aufgaben. Das ist bei Projekten mit wiederholtem Bearbeiten, Testen und dem Einsatz von Werkzeugen wichtig, bei denen Nutzer auf ein fertiges Ergebnis warten und nicht auf eine einzelne Antwort. Das Unternehmen beschreibt die technische Veröffentlichung als kleines Update, obwohl es Verbesserungen bei Schlussfolgerungen, Programmierung, Agentenaufgaben und visuellen Tests beansprucht.
Search findet Seiten, Fetch ruft sie ab
Die Dienste Search und Fetch von DeepSeek erfüllen unterschiedliche Aufgaben. Search nimmt eine Anfrage entgegen und liefert eine nach Relevanz geordnete Ergebnisliste. Fetch erhält eine bestimmte Webseite und gibt deren Titel und Inhalt als Markdown zurück, einem einfachen Textformat, das Überschriften, Listen und andere nützliche Strukturen beibehält.
Ein Entwickler könnte beispielsweise mit Search aktuelle Softwaredokumentation finden und anschließend die relevante Seite mit Fetch abrufen, bevor er das Modell um Code bittet. Anwendungen, die abgerufene Dokumente mit generierten Antworten kombinieren, werden häufig als Retrieval-Augmented-Generation-Systeme (RAG) bezeichnet.
Die Dienste verwenden die Basisadresse api.deepseek.com und dasselbe API-Anmeldedatensystem wie der Modelldienst von DeepSeek. Die Endpunkte lauten POST /v1/tools/search und POST /v1/tools/fetch. Sie liefern strukturierte JSON-Daten zurück, die Software lesen und zwischen Werkzeugen weitergeben kann.
Search akzeptiert Anfragen mit bis zu 128 Zeichen. Entwickler können zwischen einem und 50 Ergebnissen anfordern; standardmäßig werden 10 zurückgegeben. Die Ergebnisse können Titel, Adressen, kurze Zusammenfassungen, ausführlichere Zusammenfassungen für Modelle, Veröffentlichungsdaten und, sofern verfügbar, den vollständigen Seiteninhalt enthalten.
DeepSeek zufolge unterstützt die Suchmaschine bereits die Suche auf der eigenen Website und über die API und verarbeitet weltweit täglich Hunderte Millionen Anfragen. Das Unternehmen beschreibt einen Index mit Hunderten Milliarden Webseiten und die Unterstützung für Suchanfragen in mehreren Sprachen.
DeepSeek erklärt außerdem, die Suchergebnisse gegen Manipulationsversuche zu filtern, mit denen die von generativer KI ausgewählten Informationen beeinflusst werden sollen, sowie gegen minderwertige, KI-generierte Inhalte. Diese Maßnahmen betreffen die Informationen, auf die ein Agent stößt, bevor er eine Antwort formuliert oder auf eine Nutzeranfrage reagiert.
Was Entwickler zahlen und ab wann
In der englischsprachigen Mitteilung von DeepSeek werden Search und Fetch jeweils mit 0,75 US-Dollar je 1.000 Aufrufe veranschlagt. Der chinesische Preis beträgt für jeden Dienst 5 Yuan je 1.000 Aufrufe. Ein Arbeitsablauf mit einer Suche und dem Abruf einer Seite nutzt somit zwei getrennt abgerechnete Dienste.
Nach den veröffentlichten Abrechnungsregeln fällt für Search eine Gebühr an, wenn der Dienst erfolgreich eine nicht leere Ergebnisliste zurückgibt. Für Fetch wird eine Gebühr fällig, wenn der Seiteninhalt mit dem HTTP-Statuscode 200 für eine erfolgreiche Anfrage zurückgegeben wird. Fehlgeschlagene Anfragen, leere Ergebnisse und Zeitüberschreitungen sind kostenlos. Auch die angeforderte Zahl an Suchergebnissen ändert den Preis eines Suchaufrufs nicht.
Zum angegebenen Yuan-Preis würden 1.000 erfolgreiche Suchanfragen und anschließend 1.000 erfolgreiche Seitenabrufe zusammen 10 Yuan an Such- und Abrufgebühren kosten. Die Modellverarbeitung wird separat abgerechnet. Durch diese Trennung können Entwickler die Kosten eines Agenten besser kalkulieren, der während seiner Arbeit wiederholt Informationen nachschlägt.
DeepSeek zufolge sind Search- und Fetch-Aufrufe über Server-Tools in DeepSeek Harness, Claude Code und Codex für Nutzer der DeepSeek-API vorübergehend kostenlos. Die Abrechnung für diesen Zugriffsweg beginnt am 31. Oktober 2026 um 16:00 Uhr UTC, also gleichzeitig mit dem 1. November um 00:00 Uhr in Peking. Die vorübergehende Gebührenbefreiung gilt für diese Tool-Aufrufe; die üblichen Modellkosten fallen weiterhin an.
Jedes Konto kann bis zu fünf Search-Anfragen pro Sekunde und fünf Fetch-Anfragen pro Sekunde stellen; die beiden Limits werden getrennt gezählt. Für Fetch gelten außerdem zusätzliche Beschränkungen für einzelne Webseitendomains. Anfragen oberhalb der erlaubten Rate erhalten die HTTP-Antwort 429, die der Anwendung signalisiert, langsamer zu arbeiten.
Harness-Updates verbinden das Modell mit dem Arbeitsalltag
DeepSeek empfiehlt für das aktualisierte Modell Harness v0.2.1-rc.1 oder eine neuere Version. Die Buchstaben rc stehen für Release Candidate, eine für Tests vor der endgültigen Veröffentlichung vorbereitete Version. Das Modell wurde gezielt für DeepSeek Harness, Tencent CodeBuddy, WorkBuddy und andere Frameworks optimiert.
Die Harness-Veröffentlichung bietet neue Möglichkeiten, Plugins über benutzerdefinierte Indizes zu finden und einen Agenten mit der Erstellung eines Plugins zu beauftragen. Zudem wurde die Verwaltung von Abhängigkeiten verbessert, wenn Plugins aktiviert, deaktiviert, aktualisiert oder entfernt werden. Einige Änderungen an Plugins treten sofort in Kraft, für andere ist ein Neustart erforderlich.
Über die TypeScript- und Python-Softwareentwicklungskits können Entwickler nun das Arbeitsverzeichnis einer Sitzung auslesen und ändern. Zu den weiteren Neuerungen zählen experimentelle Werkzeuge zur Prüfung von Sitzungen, die Unterstützung separater Git-Arbeitsverzeichnisse sowie das automatische Maskieren von Schlüsseln und Tokens in gesendeten Nachrichten.
Die Veröffentlichung führt die Arbeit an der Claude-Code-Mods-Brücke fort, die bereits in einer früheren Harness-Alpha getestet wurde. Damals gab es drei ausführbare Beispiele und vier weitere, die wegen fehlender Schnittstellen oder Anzeigemöglichkeiten nicht funktionierten. Die Kompatibilitätsschicht bleibt experimentell. Ziel ist es, zu testen, wie sich Erweiterungen für Claude Code in Harness-Plugins integrieren lassen.
Neue Harness-Nutzer erhalten außerdem ein Werbeguthaben von 6 Yuan ohne vorherige Zahlung. Das Guthaben verfällt sieben Tage nach der Gutschrift und ist nur verfügbar, solange der Vorrat reicht. Wegen der kurzen Gültigkeit ist es eine befristete Testgutschrift für neue Nutzer.
Offene Gewichte und Bereitstellungsoptionen
In der offiziellen Mitteilung bestätigt DeepSeek, dass V4.1-Flash-1017 über Hugging Face und ModelScope verfügbar ist. Die Veröffentlichung setzt die MIT-Lizenz der V4.1-Flash-Reihe fort, die eine breite Weiterverwendung unter ihren Lizenzbedingungen erlaubt. Entwickler können sich daher zwischen einem gehosteten Dienst und dem eigenen Betrieb des Modells entscheiden.
V4.1 Flash verarbeitet Text und Bilder und erzeugt Text. Die Architektur basiert auf einer Mischung von Experten (Mixture of Experts). Dabei werden für jeden Verarbeitungsschritt ausgewählte Teile des Modells aktiviert, statt dass das gesamte Modell jedes Token verarbeitet. Die Architekturangaben nennen einen Modellkern mit 552 Milliarden Parametern, von denen bei der Eingabeverarbeitung 8 Milliarden und bei der Ausgabeerzeugung 16 Milliarden aktiv sind.
Ein Kontextfenster von rund einer Million Token ermöglicht es dem Modell, in einer Sitzung große Materialmengen zu verarbeiten. Für einen Coding-Agenten können dazu Anweisungen, Quelldateien, der bisherige Gesprächsverlauf und Werkzeugergebnisse gehören. Das Kontextfenster bestimmt, wie viel das Modell berücksichtigen kann; das Ausgabelimit legt fest, wie viel es in einer Antwort erzeugen kann.
Die Spezifikationen gehosteter Bereitstellungen können abweichen. Ein Eintrag eines Drittanbieters für die API nennt ein Kontextfenster von 1.048.576 Token und eine maximale Antwortlänge von 131.072 Token sowie Funktionsaufrufe und strukturierte Ausgaben nach einem JSON-Schema. Über Funktionsaufrufe kann das Modell ein externes Werkzeug anfordern; strukturierte Ausgaben liefern einer Anwendung ein vorhersehbares Format zur Verarbeitung.
Der gleiche Eintrag bietet eine Weiterleitung zwischen inference.net, DeepInfra und DeepSeek an. Wenn bei einem Anbieter ein Fehler auftritt, werden Anfragen an einen anderen weitergeleitet. Entwicklern stehen damit die Wahl des Modellzugangs und des Anbieters sowie die separaten Suchdienste zur Verfügung, jeweils mit eigenen Betriebseinstellungen und Kosten.
Die Termine für die Einführung
DeepSeeks Veröffentlichung im Oktober verbindet ein Modell-Update, einen Release Candidate für Harness und den öffentlichen Zugang zur Suchinfrastruktur. Bereits früher am 17. Oktober entdeckte ein automatisierter API-Tracker einen Modelleintrag mit dem Suffix 1017, der anschließend wieder verschwand. Die spätere Mitteilung von DeepSeek bestätigte die Veröffentlichung und die Änderungen auf Website, in App und API.
Die Abfolge gibt Entwicklern eine kurze Frist, ihre Werkzeuge zu aktualisieren und die Nutzung der Suche zu prüfen, bevor die vorübergehende Gebührenbefreiung endet:
- 10. September 2026: DeepSeek veröffentlicht das ursprüngliche Modell V4.1 Flash.
- 3. Oktober 2026: Harness v0.2.1-alpha.1 führt die experimentelle Claude-Code-Mods-Brücke ein.
- 17. Oktober 2026: V4.1-Flash-1017 wird auf Website, in App und API verfügbar. Search und Fetch werden für Entwickler freigeschaltet, außerdem erscheint ein aktualisierter Harness-Release-Candidate.
- 31. Oktober 2026, 16:00 Uhr UTC: Die Abrechnung berechtigter Search- und Fetch-Aufrufe über Server-Tools beginnt. Das entspricht dem 1. November um Mitternacht in Peking.
Entwickler, die deepseek-flash bereits nutzen, erhalten das aktualisierte Modell unter dem bestehenden Namen. Wer Harness verwendet, soll auch die umgebende Anwendung aktualisieren. Die praktische Neuerung ist ein enger vernetzter Arbeitsablauf: ein für längere Projekte trainiertes Modell, Werkzeuge zur Ausführung der Arbeit und ein Suchdienst, für den bald eine separate Nutzungsgebühr anfällt.
Wichtige Punkte
- DeepSeek hat V4.1-Flash-1017 am 17. Oktober 2026 auf Website, in App und API veröffentlicht.
- Das Modell bleibt unter dem Namen deepseek-flash verfügbar; Aufrufmethode und Preise der bestehenden Modell-API ändern sich nicht.
- DeepSeek gibt für DeepSWE v1.1 einen Wert von 77,0 an, gegenüber zuvor 74,2. Zudem sollen Aufgaben schneller erledigt und kürzere Ausgaben erzeugt werden.
- Zu den Projektbeispielen gehören die Modellierung der Verbotenen Stadt, ein browserbasiertes Rennspiel, eine Neuauflage von Portal 2 und Valley of Ages.
- Search und Fetch kosten jeweils 0,75 US-Dollar beziehungsweise nach chinesischem Tarif 5 Yuan je 1.000 erfolgreiche Aufrufe.
- Die Abrechnung berechtigter Aufrufe über Server-Tools beginnt am 1. November um Mitternacht in Peking.
- DeepSeek empfiehlt Harness v0.2.1-rc.1 oder eine neuere Version und hat die Modellgewichte über Hugging Face und ModelScope veröffentlicht.