Ein kleiner chinesischer KI-Computer nimmt einen teuren Konkurrenten ins Visier
Sipeed peilt für einen MaixStation-Computer mit 128 GB Arbeitsspeicher und Axeras AX8860P, einem Chip des chinesischen Herstellers, einen Preis von etwa 3.999 Dollar an. Das geplante Gerät misst nur 11 × 11 × 3 cm und soll große KI-Modelle lokal ausführen können, bei einer typischen Leistungsaufnahme von 40 Watt. Als Konkurrent ist Nvidias DGX Spark vorgesehen, ein kompaktes KI-System, das mit 128 GB etwa 6.950 Dollar kostet.
Inhalt
- Ein kleiner chinesischer KI-Computer nimmt einen teuren Konkurrenten ins Visier
- Was Axera in den AX8860P eingebaut hat
- Warum 128 GB wichtiger sind als eine hohe TOPS-Zahl
- Die offizielle Benchmark-Seite zeichnet ein engeres Bild
- Warum die früheren Geschwindigkeitsangaben sorgfältig verglichen werden müssen
- Ein taschengroßes Gehäuse mit gängigem Speicheranschluss
- Mehr Chips versprechen mehr Kapazität, die Skalierung ist jedoch noch ein Versprechen
- Das Softwareversprechen ist entscheidend für den Alltag
- Preis und Lieferung hängen nun von einer Kampagne ab
- Die wichtigsten Punkte
Axera stellte den Chip am 13. Oktober 2026 auf einer Industriemesse in Shanghai vor; zugleich präsentierte Sipeed die MaixStation. Das ursprüngliche Versprechen war beachtlich: Bei einem Qwen-Modell mit 27 Milliarden Parametern sollten Prompts 25 Prozent schneller verarbeitet und Antworten 30 Prozent schneller erzeugt werden als auf dem DGX Spark – bei etwa der Hälfte des Preises.
Sipeeds Produktseite zur MaixStation zeichnet inzwischen ein genaueres Bild. Für die Verarbeitung von Prompts mit Qwen3.8-27B nennt sie 592 bis 677 Tokens pro Sekunde und für die Antwortgenerierung 6 bis 7 Tokens pro Sekunde. Diese Werte liegen unter den rund um die Ankündigung verbreiteten Angaben. Laut offiziellem Zeitplan soll eine Kickstarter-Kampagne Ende 2026 starten.
Der konkrete Vorteil: Ein großer Arbeitsspeicher in einem kleinen Computer könnte Entwicklern, Büros und Privatnutzern ermöglichen, leistungsfähige Modelle auszuführen, ohne Cloud-Rechenleistung zu mieten oder mehrere Grafikkarten zu kaufen. Für die Kaufentscheidung sind jedoch neben den Chipdaten auch die endgültige Software, gemessene Leistung und der Lieferzeitplan ausschlaggebend.
Was Axera in den AX8860P eingebaut hat
Die AX8860-Familie wird im 6-Nanometer-Verfahren gefertigt und kombiniert 16 Arm-Cortex-A55-CPU-Kerne mit einer dedizierten neuronalen Verarbeitungseinheit, kurz NPU. Eine NPU ist ein Prozessor, der für die wiederholten Berechnungen von KI-Modellen ausgelegt ist. Axera und Sipeed geben die Leistung mit bis zu 256 Billionen Operationen pro Sekunde an, meist als 256 TOPS abgekürzt, bei Verwendung von FP4.
FP4 speichert Zahlenwerte mit einer Genauigkeit von vier Bit. Weniger Bits verringern den benötigten Speicherplatz eines Modells und können Berechnungen beschleunigen, allerdings müssen Modell und Software dieses Format unterstützen. Axeras Angabe bezieht sich auf dichte Berechnungen und nicht auf eine Berechnung, bei der davon ausgegangen wird, dass sich einige Werte mithilfe einer Technik namens Sparsität überspringen lassen.
Der Chip unterstützt PCIe 5.0 und eine Speicheranbindung mit 256 Bit Breite. Sipeed spezifiziert LPDDR5X-8533-Arbeitsspeicher mit bis zu 128 GB pro Modul und einer Bandbreite von 273 GB pro Sekunde. Das Maix-V-Modul misst 78 × 78 mm und nutzt einen LPCAMM2-Anschluss.
Die Cortex-A55-Kerne übernehmen das Betriebssystem und unterstützende Aufgaben, während die NPU die Hauptlast der KI-Berechnungen tragen soll. Nvidias DGX Spark verfügt über 20 Arm-Kerne, darunter leistungsfähigere Cortex-X925-Kerne. Konkurrenzgeräte aus AMDs Ryzen-AI-Halo-Reihe verwenden Zen-5-CPUs. Wer KI-Inferenz mit umfangreichen herkömmlichen Rechenaufgaben kombinieren möchte, muss deshalb mehr vergleichen als nur den Beschleuniger.
Warum 128 GB wichtiger sind als eine hohe TOPS-Zahl
Ein Sprachmodell benötigt Speicher für seine Zahlengewichte, in denen das während des Trainings Erlernte codiert ist, und für Arbeitsdaten, die beim Beantworten einer Anfrage entstehen. Ein schneller Beschleuniger mit zu wenig Speicher kann dazu führen, dass das Modell auf mehrere Geräte verteilt oder über langsamere Speicher geladen werden muss.
Die geplante Konfiguration der MaixStation mit 128 GB liegt in derselben Speicherkapazitätsklasse wie der größere DGX Spark. Beide geben eine Bandbreite von 273 GB pro Sekunde an. AMDs Ryzen-AI-Halo-Reihe umfasst eine Konfiguration mit 128 GB und etwa 256 GB pro Sekunde sowie eine teurere Version mit 192 GB und 273 GB pro Sekunde.
Die Kapazität bestimmt, wie viel in den Speicher passt. Die Bandbreite bestimmt, wie schnell Daten zum Prozessor gelangen. Bei der gewöhnlichen Generierung durch ein dichtes Sprachmodell müssen für jedes neue Token große Mengen Modelldaten gelesen werden. Ein Token ist eine kleine Texteinheit, manchmal ein ganzes Wort, manchmal nur ein Wortteil.
Sipeed argumentiert daher, dass eine effiziente Speichernutzung seinem 256-TOPS-Prozessor ermöglichen könne, mit Nvidias höherer beworbener Rechenleistung mitzuhalten. Die FP4-Angabe des DGX Spark von rund 1.000 TOPS nutzt Sparsität; bei dichten FP4-Berechnungen sind es etwa 500 Billionen Operationen pro Sekunde. Die tatsächliche Anwendungsgeschwindigkeit hängt außerdem davon ab, wie effizient die Software die Hardware auslastet.
Die offizielle Benchmark-Seite zeichnet ein engeres Bild
Sipeed unterscheidet bei seinen Tests zwischen Prefill, also der Verarbeitung des Nutzer-Prompts durch das Modell, und Decode, also der Generierung einer Antwort. Ein schnelleres Prefill kann die Wartezeit bis zum Beginn der Antwort verkürzen, insbesondere bei langen Dokumenten. Ein schnelleres Decode lässt die Antwort nach Beginn der Generierung schneller erscheinen.
Für Qwen3.8-27B in dichtem FP4 nennt die offizielle Seite für die MaixStation beim Prefill 592 bis 677 Tokens pro Sekunde, gegenüber 550 beim DGX Spark. Das entspricht einem Vorsprung von etwa 8 bis 23 Prozent. Die angegebene Decode-Geschwindigkeit der MaixStation liegt bei 6 bis 7 Tokens pro Sekunde; der bereitgestellte Text der offiziellen Grafik enthält für dieses Modell jedoch keinen numerischen Vergleichswert für den DGX Spark.
Für Qwen3.6-35B-A3B, ein Mixture-of-Experts-Modell, gibt Sipeed beim Prefill 2.664 bis 3.256 Tokens pro Sekunde an, gegenüber 2.368 beim DGX Spark. Der berechnete Vorsprung liegt bei etwa 13 bis 38 Prozent. Beim Decode sind es 34 bis 37 Tokens pro Sekunde gegenüber 34, also Gleichstand bis zu einem Vorsprung von etwa 9 Prozent.
Ein Mixture-of-Experts-Modell aktiviert für jedes Token nur einen Teil seines Netzwerks. Das erklärt mit, warum seine Generierungsrate deutlich höher sein kann als die eines dichten Modells mit ähnlich vielen Parametern insgesamt. Die beiden Modelltypen erfordern pro Token unterschiedlich viel Rechenarbeit.
Sipeed bezeichnet die gezeigten Ergebnisse als konservative aktuelle Messwerte und erklärt, der AX8860P werde noch optimiert. Laut Grafik wurde FP4 verwendet und Multi-Token-Prediction (MTP) deaktiviert. MTP ist eine Technik, bei der mehrere künftige Tokens gemeinsam vorhergesagt werden, um die Generierung zu beschleunigen.
Warum die früheren Geschwindigkeitsangaben sorgfältig verglichen werden müssen
Sipeeds zuvor veröffentlichte Benchmark-Spannen lagen höher: 1.400 bis 1.600 Tokens pro Sekunde beim Prefill von Qwen3.8-27B und 15 bis 17 beim Decode, gegenüber Vergleichswerten von 1.300 beziehungsweise 13 für den DGX Spark. Für das Mixture-of-Experts-Modell lagen die Spannen bei 6.300 bis 7.700 beim Prefill und 80 bis 88 beim Decode, gegenüber 5.600 und 80. In einem späteren Vergleich bezifferte Sipeed den Vorsprung der MaixStation in beiden Phasen auf etwa 10 Prozent und erklärte, neuere Messungen mit größerem Abstand seien nicht offiziell.
Wegen der niedrigeren absoluten Werte auf der offiziellen Seite sind die Testbedingungen besonders wichtig. Prompt-Länge, Zahl der gleichzeitig verarbeiteten Anfragen, Zahlenformate, Laufzeitsoftware und Treiberversionen können das Ergebnis beeinflussen. Unabhängige DGX-Spark-Tests, die in der Berichterstattung zitiert werden, erreichten für Qwen3.8-27B ohne spekulatives Decoding etwa 11,5 bis 11,6 Tokens pro Sekunde. Beim Prefill lagen die Werte je nach Software zwischen 840 und 1.900.
Eine einfache Speicherrechnung erklärt, warum der frühere Wert von 17 Tokens pro Sekunde besondere Aufmerksamkeit erhielt. Belegt das laufende Modell ungefähr 16 GB, ergeben 273 GB pro Sekunde geteilt durch 16 GB rechnerisch etwa 17 Tokens pro Sekunde, noch ohne den übrigen Speicherverkehr zu berücksichtigen. Um diesen Wert zu erreichen, müsste die beworbene Bandbreite außergewöhnlich gut ausgenutzt werden.
Entscheidend ist dabei der tatsächliche Speicherbedarf des Modells. Vier Bit multipliziert mit 27 Milliarden Parametern ergeben für die Gewichte allein etwa 13,5 GB. Zusätzliche Daten zur Skalierung von Zahlenwerten und weiterer Speicherbedarf können den Umfang erhöhen. Detaillierte, wiederholbare Tests würden Käufern helfen, die Geschwindigkeitsangaben einer konkreten Modellkonfiguration zuzuordnen.
Ein taschengroßes Gehäuse mit gängigem Speicheranschluss
Die angegebenen Maße der MaixStation entsprechen einem Volumen von 363 Kubikzentimetern. Sipeed vergleicht das mit 1.125 Kubikzentimetern beim DGX Spark. Das geplante Gehäuse wäre damit ungefähr ein Drittel so groß. Laut Unternehmen kann das Gerät über USB-C von einer geeigneten Powerbank mit 65 Watt versorgt werden.
Auf der offiziellen Seite wird die typische Leistungsaufnahme der MaixStation mit 40 Watt und die des DGX Spark mit 120 Watt angegeben. Dabei handelt es sich um die von Sipeed genannten typischen Lasten. In der ursprünglichen Berichterstattung zum AX8860 wurden für das dedizierte Modul ebenfalls 40 Watt angegeben. Auch der Umfang der Leistungsmessungen ist somit ein nützlicher Punkt für spätere Tests.
Zu den Anschlüssen zählen 10G-SFP+-Netzwerk, USB-C, ein MCIO-8i-Anschluss und ein standardmäßiger M.2-2280-Steckplatz für eine SSD. Das gängige Speicherformat bietet Käufern eine vertraute Möglichkeit, zusätzlichen Platz für Modelldateien zu schaffen, die schnell Hunderte Gigabyte belegen können.
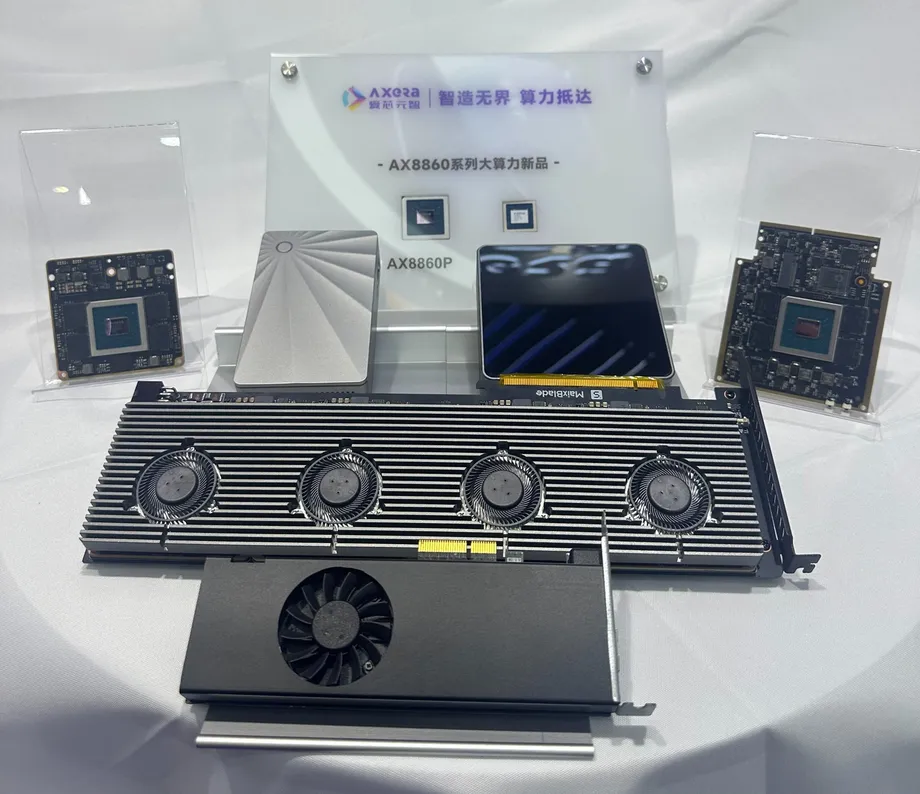
Axeras Hardwarepläne gehen über den kleinen Desktop-Computer hinaus. Vorgesehen sind ein Modul, eine PCIe-Karte mit einem Chip und eine Karte mit vier Chips, vier Lüftern und einem standardmäßigen achtpoligen Stromanschluss. Sipeed ordnet die MaixStation Pro und die MaixBlade Konfigurationen mit 512 GB oder mehr zu.
Mehr Chips versprechen mehr Kapazität, die Skalierung ist jedoch noch ein Versprechen
Sipeed zufolge kann die MaixStation bis zu acht Knoten ohne externen Switch verbinden. Dafür wird eine Chip-zu-Chip-Verbindung mit einer angegebenen Geschwindigkeit von 256 Gigabit pro Sekunde genutzt, die auf 384 Gigabit pro Sekunde erweitert werden kann. Der DGX Spark nutzt für die Verbindung von Systemen eine 200-Gigabit-Verbindung; bei einer Konfiguration mit vier Sparks ist ein externer Switch erforderlich.
Der Unterschied zwischen Gigabit und Gigabyte ist wichtig. Eine Verbindung mit 256 Gigabit pro Sekunde entspricht vor Abzug des Overheads einer Rohdatenrate von 32 Gigabyte pro Sekunde. Die Speicherbandbreite von 273 Gigabyte pro Sekunde beschreibt eine andere, deutlich schnellere Verbindung innerhalb jedes Geräts.
Axera gibt für zwei Chips zusammen 512 TOPS und für vier Chips 1.024 TOPS an und nennt zugleich eine Skalierungseffizienz von etwa 80 Prozent. Der Skalierungswert für vier Chips stammt aus einer Laborsimulation. Ein Modell auf mehrere Prozessoren zu verteilen verursacht zudem Kommunikations- und Synchronisierungsaufwand. Die Anwendungsgeschwindigkeit hängt daher von mehr ab, als nur deren Spitzenwerte zusammenzurechnen.
Axeras Roadmap sieht einen AX8950 mit bis zu 500 TOPS und einen AX8970 mit mehr als 700 TOPS vor. Diese geplanten Prozessoren würden spätere Upgrades ermöglichen. Das unmittelbare Angebot der MaixStation stützt sich jedoch auf den AX8860P und seine Software.
Das Softwareversprechen ist entscheidend für den Alltag
Sipeed nennt Debian 13 mit Linux 6.18 sowie Unterstützung für vLLM, SGLang, PyTorch, llama.cpp und Ollama. Diese Werkzeuge helfen dabei, Modelle zu laden, Anfragen zu verarbeiten und KI-Anwendungen mit der Hardware zu verbinden. Das Unternehmen wirbt außerdem mit OpenAI- und Anthropic-kompatiblen APIs, über die bestehende Anwendungen Anfragen an ein lokales Gerät senden können.
Sipeed erläutert in den Produkt-FAQ, dass die bekannten Frameworks auf einer eigens für Axera-Hardware entwickelten Software aufsetzen:
SGLang und vLLM laufen über ein angepasstes Backend zur Hardwarebeschleunigung, dessen Kernel in AXDSL geschrieben sind.
Kernel sind kleine Softwarekomponenten, die grundlegende Berechnungen auf dem Beschleuniger ausführen. Laut Sipeed können Nutzer unterstützte Hugging-Face-Modelle direkt laden; für neue Modellarchitekturen könnten jedoch in AXDSL geschriebene Kernel erforderlich sein. Das Unternehmen verspricht, Kernel und Entwicklungstools zu veröffentlichen, und erklärt, dass die Öffnung des AX8860-Softwareentwicklungskits bereits in Arbeit sei.
Das Unternehmen wirbt mit Modellen und einer Browseroberfläche, die beim Start sofort einsatzbereit sind. Als mögliche Anwendungen nennt es Coding-Agenten, Dokumentenverarbeitung, Videogenerierung und Robotik. Zunächst werden PCIe-Karten auf Linux-Systemen unterstützt; die Unterstützung für Windows hängt von der Nachfrage ab. Bei der Ankündigung sollte die NPU-Werkzeugkette bis Ende Oktober verfügbar sein.
Preis und Lieferung hängen nun von einer Kampagne ab
Sipeeds geplanter Preis von 3.999 Dollar für 128 GB läge rund 2.951 Dollar beziehungsweise 42 Prozent unter dem Preis von 6.950 Dollar für einen DGX Spark. Das wäre ein erheblicher, aber weniger als halb so hoher Preis. Außerdem läge die MaixStation damit nahe am Preis von etwa 3.999,99 Dollar für einen AMD Ryzen AI Halo mit 128 GB.
Der Zeitplan hat sich gegenüber der ursprünglichen Erwartung geändert, dass die Geräte noch 2026 auf den Markt kommen. Reservierungen sind möglich, doch laut den offiziellen FAQ ist die Kickstarter-Kampagne für Ende 2026 geplant. Sipeed will innerhalb von drei Monaten nach Ende der Kampagne mit dem Versand beginnen.
- 13. Oktober 2026: Axera stellte die AX8860-Familie in Shanghai vor, Sipeed präsentierte die MaixStation.
- Ende Oktober 2026: Sipeed erwartete die Verfügbarkeit der NPU-Werkzeugkette.
- Ende 2026: Sipeed plant seine Kickstarter-Kampagne für die MaixStation.
- Innerhalb von drei Monaten nach Ende der Kampagne: Sipeeds angepeilter Versandbeginn.
Sipeed hat weder einen endgültigen Verkaufspreis noch einen verbindlichen Liefertermin oder unabhängig überprüfte Leistungswerte der MaixStation bestätigt. Auch Produktionskapazitäten, Supportregelungen sowie Preis und Zeitplan für die 512-GB-Pro-Version sind noch offen. Während der Kampagne sind Fernzugriff und Testgeräte geplant. Damit erhalten potenzielle Käufer eine weitere Gelegenheit, die Versprechen zu überprüfen.
Die wichtigsten Punkte
- Die MaixStation soll mit 128 GB Arbeitsspeicher und einem Axera-AX8860P-Prozessor, der bei dichtem FP4 mit 256 TOPS angegeben wird, etwa 3.999 Dollar kosten.
- Sipeed nennt eine Speicherbandbreite von 273 GB pro Sekunde, eine typische Leistungsaufnahme von 40 Watt und ein Gehäuse mit den Maßen 11 × 11 × 3 cm.
- Die offizielle Benchmark-Seite weist niedrigere absolute Geschwindigkeiten aus als die früher veröffentlichten Werte; die Ergebnisse variieren je nach Modell und Verarbeitungsphase.
- Die Softwareunterstützung basiert auf einem angepassten Axera-Backend zur Beschleunigung. Entwicklungstools und weiterer Code sollen öffentlich bereitgestellt werden.
- Die Kickstarter-Kampagne ist für Ende 2026 geplant; anschließend soll der Versand laut Zielvorgabe innerhalb von drei Monaten nach Kampagnenende beginnen.
- Unabhängige Tests, endgültige Preise und verbindliche Lieferzusagen werden darüber entscheiden, wie das geplante System im Vergleich zu Alternativen von Nvidia und AMD abschneidet.