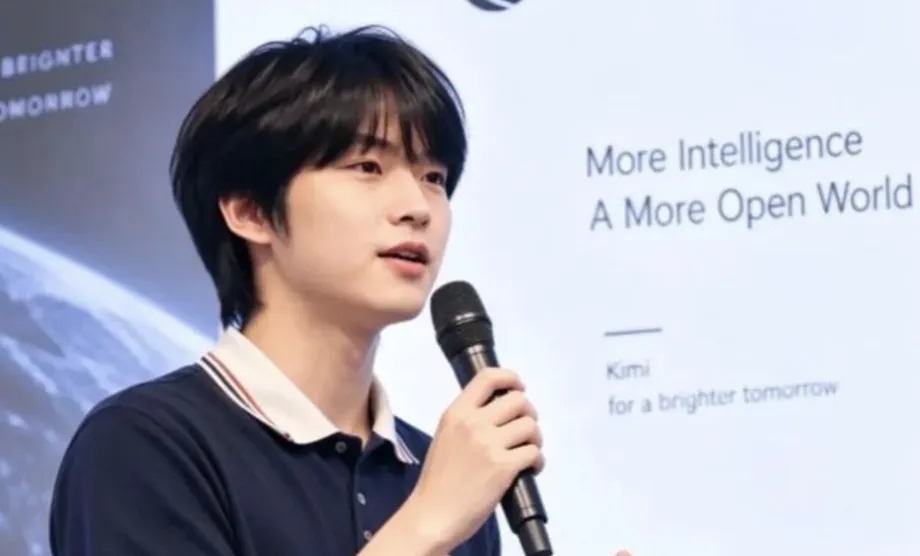
Ein jugendlicher Forscher geht, nachdem er bei der Neugestaltung von Kimi geholfen hat
Chen Guangyu, ein 17-jähriger Forscher, der an einer neuen Methode mitgewirkt hat, mit der Modelle künstlicher Intelligenz Informationen zwischen ihren Schichten weitergeben können, gab am 15. Oktober 2026 bekannt, dass er Moonshot AI, das chinesische Unternehmen hinter Kimi, verlassen hat. Er war im November 2025 im Alter von 16 Jahren zum Forschungsteam gestoßen.
Inhalt
- Ein jugendlicher Forscher geht, nachdem er bei der Neugestaltung von Kimi geholfen hat
- Was Chen zur Forschung beigetragen hat
- Wie Attention Residuals ein Modell verändert
- Was die veröffentlichten Ergebnisse zeigen
- Vom Schul-Hackathon ins Forschungsteam
- Die Stationen eines rasanten Aufstiegs
- Anthropics Einladung und die Geschichte von den Millionenangeboten
- Warum Discovery Loop ins Gespräch kam
- Was sein Abschied für Moonshot bedeutet
- Die wichtigsten Punkte
Der international als Nathan Chen bekannte Teenager aus Shenzhen geht mit einem konkreten Forschungsbeitrag: Er ist gleichberechtigter Erstautor von Attention Residuals, einem am 16. März 2026 gemeinsam mit den Moonshot-Forschern Yu Zhang und Jianlin Su veröffentlichten Paper. Berichten über die Veröffentlichung des Modells im Juli zufolge wurde die Technik später Teil von Kimi K3.
Die veröffentlichten Experimente von Moonshot vermitteln ein genaueres Bild der Arbeit als die Aufmerksamkeit, die sein Alter auf sich gezogen hat. In Tests mit einem Kimi-Linear-Modell mit 48 Milliarden Parametern verzeichneten die Forscher bei jeder untersuchten Aufgabe Verbesserungen. Ihre Methode Block Attention Residuals erreichte zudem denselben Trainingsverlust wie ein herkömmliches Modell, dem 1,25-mal so viel Rechenleistung zur Verfügung stand.
Chens Abschied hat eine öffentliche Einladung von Anthropic, Spekulationen über ein von ehemaligen Google-Forschern gegründetes Startup sowie Versuche ausgelöst, ihn mit einem nicht namentlich genannten Teenager in Verbindung zu bringen, der angeblich fünf Jobangebote im Wert von jeweils etwa einer Million US-Dollar oder mehr erhalten hat.
Chen hat jedoch öffentlich zurückgewiesen, dass er zu Anthropic wechselt. Wer sein nächster Arbeitgeber sein wird, wie ein mögliches Vergütungspaket aussieht und ob er an die Universität zurückkehren wird, ist weiterhin unbestätigt.
In seiner Abschiedsbotschaft beschrieb Chen seine Zeit bei Moonshot und dankte den Menschen, die ihn eingestellt hatten. Der scheidende Praktikant im Bereich Machine-Learning-Forschung sagte:
Das vergangene Jahr war das beste meines Lebens.
Seine Botschaft endete mit dem Wunsch, weiter auf Entdeckungsreise zu gehen, statt ein konkretes Ziel zu nennen.
Was Chen zur Forschung beigetragen hat
Chens Name steht neben Zhang und Su unter dem Vermerk „gleichberechtigter Beitrag“ im Bericht des Kimi-Teams zu Attention Residuals. Dieser Vermerk würdigt die maßgeblichen Beiträge aller drei zu einer deutlich größeren gemeinsamen Forschungsarbeit.
Su, der für seine Arbeit an rotatorischen Positionseinbettungen (RoPE) bekannt ist, führte die ersten Experimente durch. RoPE hilft einem Sprachmodell nachzuvollziehen, an welcher Stelle einer Sequenz Wörter oder andere Informationen vorkommen. Zhang war Erstautor der Forschungsarbeit zur Kimi-Linear-Architektur.
Su hat Zhang und Chen zugeschrieben, die frühe Idee von Attention Residuals zu einer für große Modelle praxistauglichen Methode weiterentwickelt zu haben. Gemeinsam schlugen sie Block AttnRes vor, eine Variante, die die Vorteile bewahren und zugleich den Speicher- und Kommunikationsaufwand bei der Anwendung der Methode in großem Maßstab verringern soll.
Chen arbeitete außerdem daran, Rechenkerne für Kimi Delta Attention (KDA) zu beschleunigen. Ein Kernel ist ein kleines Programm, das eine bestimmte Berechnung auf einer Grafikprozessoreinheit ausführt. Wird er verbessert, kann dieselbe Hardware eine Aufgabe schneller erledigen.
Seine Arbeit erstreckte sich somit auf zwei miteinander verbundene Bereiche: die Frage, wie ein Modell aufgebaut sein sollte, und die effiziente Ausführung der Berechnungen, die hinter diesem Entwurf stehen. Für ein Forschungslabor, das große Modelle trainiert, beeinflussen beide Bereiche, wie viel Forschung sich mit dem verfügbaren Rechenbudget betreiben lässt.
Wie Attention Residuals ein Modell verändert
Sprachmodelle verarbeiten Informationen über viele aufeinanderfolgende Schichten hinweg. Jede Schicht verändert die Informationen, die sie erhält, und baut so Repräsentationen auf, die spätere Schichten nutzen, um eine Antwort vorherzusagen.
Herkömmliche Residualverbindungen halten frühere Informationen in diesem Prozess verfügbar, indem sie die Ausgaben der Schichten addieren. Im offiziellen Forschungs-Repository von Moonshot wird ein Problem dieses Ansatzes beschrieben: Je tiefer das Modell wird, desto stärker kann die wiederholte Akkumulation einzelne Beiträge verwässern und die Größe interner Signale anwachsen lassen.
Attention Residuals ersetzt diese feste Akkumulation durch einen lernbasierten Auswahlprozess. Eine spätere Schicht kann Informationen aus früheren Schichten je nach aktueller Eingabe unterschiedlich gewichten. Man kann es sich wie einen Leser vorstellen, der die nützlichsten Notizen aus vorherigen Kapiteln heranzieht, statt alle Notizen mit gleicher Gewichtung weiterzutragen.
Wird diese Auswahl für jede frühere Schicht einzeln getroffen, entstehen dadurch neue Kosten. Block AttnRes fasst Schichten in Gruppen zusammen, behält die üblichen Additionen innerhalb jeder Gruppe bei und wählt zwischen den daraus entstehenden Gruppenrepräsentationen aus. Laut Repository reichen etwa acht Gruppen aus, um den Großteil der Vorteile des vollständigen Verfahrens zu erzielen.
Die größte im Paper beschriebene Kimi-Linear-Konfiguration umfasste 54 Schichten, die jeweils in Sechsergruppen zusammengefasst waren. Ihre neun Gruppen lieferten zusammen mit der anfänglichen Token-Repräsentation zehn Informationsquellen für die Auswahl. Dieser praktische technische Schritt trug dazu bei, die Idee vom Experiment in Richtung des Trainings großer Modelle weiterzuentwickeln.
Was die veröffentlichten Ergebnisse zeigen
Im Paper vom März wurde Attention Residuals in einem Kimi-Linear-Modell mit insgesamt 48 Milliarden Parametern getestet, von denen bei der Verarbeitung drei Milliarden aktiviert wurden. Parameter sind die erlernten numerischen Einstellungen innerhalb eines Modells. Wenn nur ein Teil davon aktiviert wird, kann ein Modell auf einen großen Pool erlernten Wissens zurückgreifen und zugleich den Rechenaufwand pro Schritt begrenzen.
Das Training erfolgte mit 1,4 Billionen Tokens, also den Text- oder anderen Dateneinheiten, die ein Modell verarbeitet. Die Forscher ließen die übrigen wichtigen Architekturkomponenten des Modells unverändert und konnten so die Ergänzung durch Attention Residuals mit dem Ausgangsentwurf vergleichen.
Bei GPQA-Diamond, einem Test mit schwierigen naturwissenschaftlichen Fragen, stieg der Wert von 36,9 auf 44,4, ein Zuwachs von 7,5 Punkten. HumanEval, ein Test zur Codegenerierung, verbesserte sich von 59,1 auf 62,2. MMLU, ein breit angelegter Wissenstest, stieg von 73,5 auf 74,6.
Auch der Vergleich des Rechenaufwands ist aufschlussreich. Ein Ausgangsmodell zu erreichen, das das 1,25-Fache an Rechenleistung nutzt, bedeutet, denselben angegebenen Trainingsverlust mit vier Fünfteln des dafür verwendeten Budgets oder 20 Prozent weniger Rechenleistung zu erzielen. Der Trainingsverlust misst, wie weit die Vorhersagen eines Modells während des Trainings von den Zielantworten abweichen.
Moonshot erklärte gesondert, die Technologie habe bei K3 zu einer Verbesserung der Trainingseffizienz um etwa 25 Prozent bei weniger als zwei Prozent zusätzlichem Aufwand beigetragen. Die Experimente vom März und die späteren Angaben zu K3 beziehen sich auf unterschiedliche Modelleinstellungen; die oben genannten detaillierten Benchmark-Ergebnisse stammen von Kimi Linear.
Vom Schul-Hackathon ins Forschungsteam
Chen wurde 2009 in Shenzhen geboren. Vor seinem Einstieg bei Moonshot organisierte er eine Open-Source-Community für Jugendliche, entwickelte Software-Bots und beschäftigte sich mit Themen von KI-Sicherheit bis Physik.
Während der Vorbereitung auf seine Universitätsbewerbungen legte er einige Aktivitäten, die ihm keinen Spaß machten, auf Eis und begann, sich in Themen einzulesen, die ihn interessierten. Sein anschließender Weg in die Forschung verband selbstständiges Lernen, öffentliche technische Beiträge und den Austausch mit aktiven Forschern.
Im Februar 2025 nahm er mit ThirdArm, einem Projekt für einen zusätzlichen robotischen Hilfsarm, an einem Moonshot-AI-Hackathon für Schülerinnen und Schüler teil. Dort traf er Dong Kehan, ein Mitglied des Gründungsteams von MiraclePlus, der ihm empfahl, sich auf Spitzentechnologie zu konzentrieren.
Ein technischer Beitrag über DeltaNet zog daraufhin eine Antwort des Forschers Songlin Yang nach sich. Der Austausch erreichte Ben Keigwin von Tilde Research, einem Startup im kalifornischen Palo Alto, und führte zu einem Gespräch über dessen Arbeit. Im Juli 2025 reiste Chen im Alter von 16 Jahren allein dorthin, um ein siebenwöchiges Praktikum zu absolvieren.
Zu Chens Lernmethode gehörte es, stundenlang mit Gemini über Papers zu diskutieren, Screenshots schwieriger Passagen zu senden und Rückfragen zu stellen. Außerdem las er Code, Blogs und die Websites von Forschern und bat den DeepSeek-Forscher Yuan Jingyang bei wichtigen Entscheidungen um Rat.
Seine Erfahrung zeigt mehr als den Einsatz eines Chatbots als Lernhilfe. Durch öffentliche Beiträge wurde sein technisches Denken sichtbar, Forscher reagierten darauf und Praktika boten ihm die Gelegenheit, dieses Denken in die gemeinsame Arbeit einzubringen.
Die Stationen eines rasanten Aufstiegs
In weniger als zwei Jahren führte Chens Weg von einem Schulprojekt über ein internationales Praktikum bis hin zu veröffentlichter Modellforschung. Sein Abschied folgte auf den Einsatz von Attention Residuals in einer wichtigen Kimi-Veröffentlichung.
- Februar 2025: Chen nahm an Moonshots KI-Hackathon für Schülerinnen und Schüler teil.
- Juli 2025: Er begann ein siebenwöchiges Praktikum bei Tilde Research in Palo Alto.
- November 2025: Mit 16 Jahren stieß er als Praktikant im Bereich Machine-Learning-Forschung zum Kimi-Team von Moonshot.
- 16. März 2026: Der technische Bericht zu Attention Residuals wurde veröffentlicht; Chen, Zhang und Su wurden gleichberechtigt als Autoren genannt.
- Juni 2026: Chen machte seinen Highschool-Abschluss.
- Juli 2026: Kimi K3 wurde mit Attention Residuals als einer seiner Architekturtechnologien veröffentlicht.
- 15. Oktober 2026: Chen gab seinen Abschied von Moonshot bekannt.
- 16. Oktober 2026: Er wies Spekulationen zurück, er werde zu Anthropic wechseln.
- 20. Oktober 2026: Ein anonymes Konto behauptete, er werde zu Discovery Loop wechseln.
In den öffentlich zugänglichen Angaben zu seiner Ausbildung ist außerdem ein Studium an der Carnegie Mellon University im August und September 2026 aufgeführt. Dieser kurze Eintrag ist Teil der Spekulationen darüber geworden, ob sein nächster Schritt eine Stelle oder ein weiteres Studium sein wird.
Anthropics Einladung und die Geschichte von den Millionenangeboten
Sholto Douglas, der bei Anthropic den Bereich skalierbares Reinforcement Learning leitet, kommentierte Chens Abschiedsbeitrag. Er fragte, ob Chen weiterhin an die Carnegie Mellon University gehen wolle, und lud ihn ein, mit ihm in San Francisco zusammenzuarbeiten.
Chen antwortete, dass er in die Bay Area unterwegs sei. Als der Austausch Spekulationen auslöste, er sei zu Anthropic gewechselt, wies er diese kurz zurück:
nein :)
Die Gehaltsdebatte begann unabhängig davon. Der Investor von Menlo Ventures, Deedy Das, berichtete von einem Treffen mit einem nicht namentlich genannten 17-Jährigen, der sich mithilfe von Sprachmodellen KI selbst beigebracht, etwa ein Jahr bei einem führenden KI-Unternehmen Praktika absolviert und ein hoch angesehenes US-Grundstudium nach zwei Wochen abgebrochen habe.
Das zufolge hatte dieser Teenager fünf Angebote von führenden KI-Laboren in San Francisco erhalten, jedes im Wert von etwa einer Million US-Dollar oder mehr. Das gab auch die Aussage des Teenagers weiter, ihm sei Lernen wichtiger als Geld.
Nutzer sozialer Medien brachten diese Beschreibung wegen seines Alters und seiner Forschungserfahrung mit Chen in Verbindung. Das nannte den Teenager nicht, und Chen hat nicht bestätigt, dass die Angebote an ihn gerichtet waren. In der Debatte geht es daher um die angeblichen Angebote für eine nicht namentlich genannte Person und nicht um einen offengelegten Arbeitsvertrag für Chen.
Die öffentliche Einladung von Douglas ist ein konkreteres Zeichen des Interesses: Ein leitender Forscher ermutigte Chen öffentlich, sich ihm anzuschließen. Die anschließende Zurückweisung gibt zudem eine direkte Antwort auf die Spekulationen über Anthropic.
Warum Discovery Loop ins Gespräch kam
Discovery Loop rückte in den Mittelpunkt, nachdem Arfur Grok, ein anonymes Konto, das Personalwechsel in der KI-Branche verfolgt, am 20. Oktober behauptet hatte, Chen sei zum Unternehmen gewechselt. Chen hat eine Anstellung dort nicht bestätigt, und das Startup lehnte eine Stellungnahme zu Personalfragen ab.
Das Unternehmen wurde im August 2026 von den ehemaligen Google-Forschern Jeff Dean, Sanjay Ghemawat, Quoc Le und Oriol Vinyals gegründet. Nach eigenen Angaben will es KI einsetzen, um wissenschaftliche Forschung und Machine-Learning-Forschung zu automatisieren, einschließlich der Entwicklung von Ideen, der Durchführung von Experimenten und der Analyse von Ergebnissen.
Für einen Forscher, der sich für effizientes Modelldesign interessiert, würde diese Mission vertraute technische Probleme mit sich bringen. Systeme, die zahlreiche Forschungsexperimente durchführen, müssen Rechenressourcen effizient nutzen. Verbesserungen an Algorithmen oder Kernels können dafür sorgen, dass sich mit einem festen Budget mehr Experimente durchführen lassen.
Auch die Finanzierung von Discovery Loop hat Aufmerksamkeit erregt. Im September soll das Unternehmen Finanzmittel auf Basis einer Bewertung von etwa 50 Milliarden US-Dollar gesucht haben, nachdem noch wenige Wochen zuvor über rund zehn Milliarden US-Dollar gesprochen worden war. Das entspricht einer Verfünffachung. Diese Zahlen beziehen sich auf vorgeschlagene Unternehmensbewertungen während der Finanzierungsverhandlungen.
Durch Tilde Research besteht zudem bereits eine Verbindung Chens zur Bay Area. Sein früheres Praktikum dort hilft zu erklären, warum eine Reise nach Kalifornien mit mehreren beruflichen Kontakten verbunden sein könnte und nicht zwangsläufig mit einem einzigen naheliegenden Ziel.
Was sein Abschied für Moonshot bedeutet
Der Moonshot-Forscher Du Yulun, der sich dafür eingesetzt hatte, Chen im Alter von 16 Jahren einzustellen, sagte, die beiden hätten mehrere lange Gespräche über dessen Entscheidung zu gehen geführt. Du äußerte seine Trauer und unterstützte zugleich Chens Wunsch, in seinem Alter neue Interessen zu erkunden.
Chens Beiträge bleiben Teil der Forschungsarbeit des Teams. Das im Juli mit 2,8 Billionen Parametern veröffentlichte Kimi K3 kombiniert Attention Residuals mit Kimi Delta Attention. Die beiden Technologien betreffen unterschiedliche Aspekte der Informationsverarbeitung: AttnRes verändert, wie Informationen durch die Tiefe des Modells fließen, während KDA die effiziente Verarbeitung von Sequenzen unterstützt.
Moonshot führte eine ungefähr 2,5-fache Verbesserung der Skalierungseffizienz von K3 gegenüber K2 auf das Zusammenspiel von Architekturänderungen, Trainingsmethoden und Datenauswahl zurück. Chens Arbeit ist damit Teil einer umfassenderen Unternehmensleistung, an der viele Forscher beteiligt waren und die mehrere technische Änderungen umfasst.
Die praktischen Auswirkungen reichen über die Karriere eines ungewöhnlich jungen Mitarbeiters hinaus. Ein Modell, das effizienter lernt, kann teure Prozessoren und Forschungsbudgets besser nutzen. Ein Forscher, der mathematische Entwürfe mit einer schnellen Umsetzung verbinden kann, leistet dazu einen direkten Beitrag.
Chen verlässt Moonshot mit veröffentlichter Forschungsarbeit, Erfahrungen in zwei Forschungsumgebungen und dem öffentlichen Interesse eines weiteren führenden Labors. Die bestätigte Geschichte ist bereits beachtlich: Ein Teenager half dabei, eine Architekturidee in eine anwendbare Methode zu verwandeln, und entschied sich dann, seine Möglichkeiten weiter auszuloten, bevor er seine nächste Stelle bekannt gab.
Die wichtigsten Punkte
- Chen Guangyu, auch bekannt als Nathan Chen, gab am 15. Oktober 2026 im Alter von 17 Jahren seinen Abschied von Moonshot AI bekannt.
- Bei dem am 16. März veröffentlichten Paper zu Attention Residuals wurde er gemeinsam mit Yu Zhang und Jianlin Su gleichberechtigt als Erstautor genannt.
- Moonshots Experimente zeigten Verbesserungen bei allen untersuchten Aufgaben und erreichten die Ergebnisse eines Vergleichsmodells, das 1,25-mal so viel Rechenleistung nutzte.
- Chen wirkte an der Entwicklung von Block AttnRes mit und arbeitete daran, die Berechnungen von Kimi Delta Attention zu beschleunigen.
- Er sagte, er sei in die Bay Area unterwegs, und wies Spekulationen zurück, er werde zu Anthropic wechseln.
- Ein behaupteter Wechsel zu Discovery Loop und Spekulationen, die ihn mit fünf Angeboten im Wert von jeweils etwa einer Million US-Dollar in Verbindung bringen, sind unbestätigt.