111 private Beiträge legen eine Lücke in Taiwans KI-Ambitionen offen
Taiwans staatliche KI-Trainingssammlung umfasst inzwischen 7.161 Datensätze, doch nur 111 davon stammen von privaten Beitragenden. Das entspricht rund 1,6 Prozent der Gesamtmenge – ein geringer Anteil für ein Projekt, das künstlicher Intelligenz Taiwans Sprache, Kultur und Alltag näherbringen soll.
Inhalt
- 111 private Beiträge legen eine Lücke in Taiwans KI-Ambitionen offen
- Was die staatliche Sammlung umfasst
- Warum lokale Sprache wichtig ist
- Eine Strafanzeige veränderte die Abwägung
- Welche Rolle das Urheberrecht beim KI-Training spielt
- Freiwillige Genehmigung statt Übertragung des Eigentums
- Für entgeltliche Kooperation gibt es bereits ein kleines Beispiel
- Gesetzliche Ausnahmen und Sammellizenzen als konkurrierende Ansätze
- TAIDE zeigt, warum sowohl Zugang als auch Ressourcen wichtig sind
- Die wichtigsten Punkte
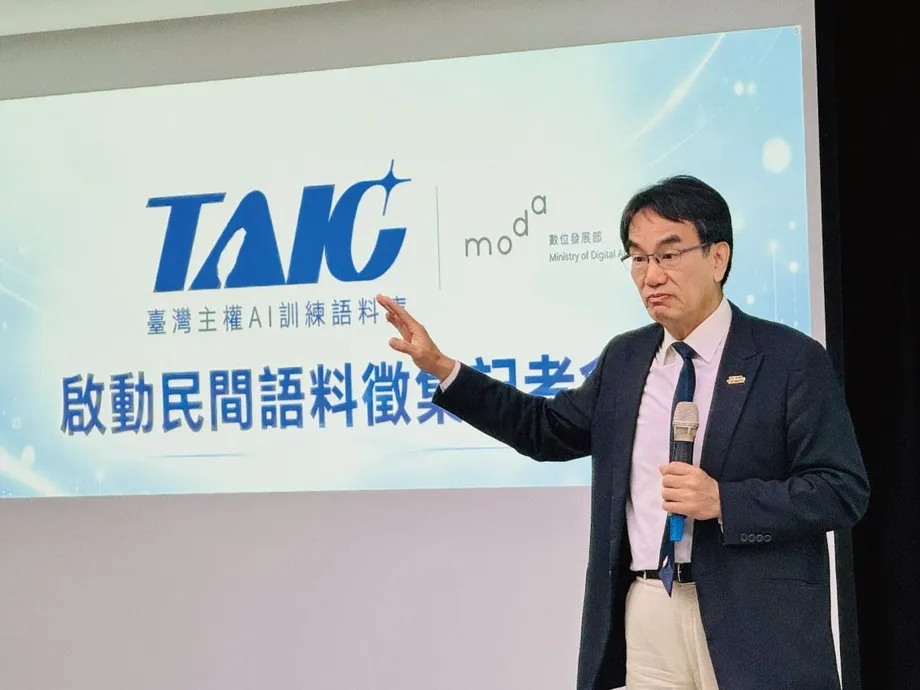
Das Ministerium für Digitales startete das Taiwan Sovereign AI Training Corpus am 24. Dezember 2025. Mehr als 200 staatliche Stellen steuerten über 2.000 Datensätze mit insgesamt 600 Millionen Tokens bei. Tokens sind die kleinen Texteinheiten, die KI-Systeme verarbeiten: mal ein einzelnes Zeichen, mal ein Wortteil.
Die Beteiligung staatlicher Stellen hat den Aufbau einer umfangreichen Sammlung ermöglicht. Verlage, Autoren, Bildungsplattformen und Nachrichtenorganisationen einzubeziehen, ist schwieriger: Entwickler benötigen die Erlaubnis, wertvolle Texte für das Training zu kopieren, während Rechteinhaber eine Vergütung und Kontrolle darüber wünschen, wie ihre Werke genutzt werden.
Bei einer Anhörung im Parlament am 14. Oktober 2026 erklärte Digitalminister Lin Yi-jing, die private Beteiligung sei freiwillig. Die Regierung wolle, dass große KI-Unternehmen, insbesondere US-amerikanische, für Trainingsinhalte bezahlen. Nachrichteninhalte sind vom aktuellen Programm zur Sammlung privater Beiträge ausgenommen.
Die praktischen Folgen reichen über den Umfang einer Datenbank hinaus. Ein mit taiwanischen Texten trainiertes Modell kann lokale Begriffe lernen, kulturelle Traditionen erklären und Fragen mit Blick auf Taiwans Institutionen beantworten. Zugleich sind die Autoren und Organisationen, die diese Inhalte erstellen, auf deren wirtschaftlichen Wert angewiesen. Taiwan versucht, den Zugang zu ihren Werken auszuweiten und zugleich zu klären, wer dafür bezahlen soll, welche Nutzungserlaubnis gilt und wo das Urheberrecht präzisiert werden muss.
Was die staatliche Sammlung umfasst
Die Ankündigung zum Start im Dezember des Ministeriums beschreibt eine Sammlung zu Sprache, Kultur, Bildung, Biologie und Geografie. Sie greift auf mehr als zehn Jahre staatlicher Open Data zurück und ermöglicht es Nutzern, Material zu durchsuchen und herunterzuladen.
Das Kulturministerium stellte Datensätze zu öffentlicher Kunst und Kulturgütern bereit. Das Bildungsministerium steuerte Wörterbuchdaten zu Taiwanisch, Hakka und Mandarin bei. Diese Ressourcen liefern Entwicklern Informationen über lokale Bedeutungen und Sprachgebrauch sowie über Orte, Gegenstände und Traditionen.
In der Beschreibung des Korpusprogramms nennt das Ministerium auch den Rat für indigene Völker und den Hakka-Rat als beteiligte Stellen. Geplant sind Inhalte zu Geschichte, kulturellem Erbe, Tourismus und lokaler Kultur. Nach Angaben des Ministeriums sollten geeignete Trainingstexte zusammenhängend, vollständig und flüssig sein.
Die dem Parlament vorgelegten Zahlen für September 2026 beziffern die Sammlung auf mehr als 5.000 Datensätze und über 2,4 Milliarden Tokens. Gegenüber den zum Start angekündigten 600 Millionen Tokens ist das, gemessen an der Tokenzahl, mehr als viermal so viel Text. Die 7.161 Einträge und 111 privaten Beiträge geben einen weiteren Einblick in die Zusammensetzung.
Warum lokale Sprache wichtig ist
Wu Che-yu, der Medienkünstler und Gründer des gemeinschaftlichen Wissensprojekts Taiwan.md, hält traditionelle chinesische Schrift in den Trainingsdaten verbreiteter KI-Systeme für zu wenig vertreten. Ihr Anteil an den chinesischsprachigen Trainingsmaterialien liege unter einem Prozent, schätzt er. Diese Zahl führt er zur Erklärung seines Projekts an.
Wu geht es um mehr als die Umwandlung vereinfachter in traditionelle Schriftzeichen. Taiwan und China verwenden für manche alltäglichen Dinge unterschiedliche Wörter, und ein Ausdruck kann jeweils eine andere Bedeutung haben. Lokales Wissen umfasst zudem Institutionen, Geschichte und Essen – darunter Gerichte, die international weniger bekannt sind als Bubble Tea oder Suppenklöße.
Taiwan.md nutzt KI-Werkzeuge, um Informationen aus dem Internet zusammenzutragen und Artikel über Natur, Gesellschaft und Geschichte Taiwans zu bearbeiten. Die 1.123 Artikel stützen sich auf öffentlich zugängliche wissenschaftliche Arbeiten, Blogs und staatliche Informationen. Wu möchte, dass verbreitete Modelle wie ChatGPT, Gemini und Claude auf mehr Texte stoßen, die taiwanische Erfahrungen widerspiegeln.
Das Ministerium bezeichnet das damit verbundene Ziel als souveräne KI: KI-Ressourcen und -Fähigkeiten zu entwickeln, die Taiwan an den eigenen Bedürfnissen ausrichten kann. Das Korpus stellt Trainingsmaterial bereit; Projekte wie Taiwan.md wollen lokales Wissen für KI-Entwickler leichter auffindbar machen.
Eine Strafanzeige veränderte die Abwägung
Im Juli 2025 wurde gegen einen Doktoranden der National Taiwan University eine Strafanzeige wegen Urheberrechtsverletzung gestellt. Er hatte ein Korpus in traditioneller chinesischer Schrift mit 140.000 nicht genehmigten Artikeln der Central News Agency verbreitet. Der Student hatte das Material von einer US-amerikanischen Website mit frei zugänglichen Ressourcen zusammengetragen und die Sammlung kostenlos geteilt.
Die Parteien einigten sich später. Der Student entschuldigte sich, rief Forschende dazu auf, die Rechtmäßigkeit ihrer Datenquellen zu prüfen, und entfernte das gesamte Korpus.
Wu zufolge hat der Fall unabhängige Entwickler vorsichtiger gemacht. Das Team von Taiwan.md verwirft Material, sobald es ein mögliches Urheberrechtsproblem erkennt. Dadurch wächst die Sammlung langsamer. Für ein kleines Projekt bedeutet die Möglichkeit eines Strafverfahrens ein persönliches Risiko bei einer ohnehin schwierigen Prüfung der Nutzungsrechte.
Mehrere Datenpunkte zeigen, wie sich die Debatte entwickelt hat:
- Anfang 2023: Der Nationale Rat für Wissenschaft und Technologie startete das Sprachmodellprojekt TAIDE mit einer Förderung von mehr als 200 Millionen NT-Dollar.
- Juli 2025: Gegen den Doktoranden wurde wegen des Korpus mit nicht genehmigten Nachrichtenartikeln eine Anzeige gestellt.
- 24. Dezember 2025: Das Ministerium für Digitales kündigte sein Korpus für souveräne KI mit 600 Millionen Tokens an.
- September 2026: Nach Angaben des Ministeriums umfasste die Sammlung mehr als 5.000 Datensätze und über 2,4 Milliarden Tokens.
- 14. Oktober 2026: Minister Lin erklärte im Parlament, private Beiträge seien freiwillig und entgeltliche Vereinbarungen über Inhalte seien ein politisches Ziel.
Welche Rolle das Urheberrecht beim KI-Training spielt
Chen Chi-tung, ein leitender Anwalt der Kanzlei Luguo, sieht das Kopieren als zentrale Rechtsfrage. Entwickler müssen Texte in der Regel vervielfältigen, bevor sie ein Modell damit trainieren können. Das Urheberrecht gibt Rechteinhabern die Kontrolle über die Vervielfältigung, vorbehaltlich Ausnahmen wie der zulässigen Nutzung.
Die zulässige Nutzung erlaubt unter bestimmten Umständen die Verwendung geschützter Werke ohne Genehmigung. Chen zufolge gehen die geltenden Bestimmungen in Taiwan nicht ausdrücklich auf KI-Training ein. Für Entwickler bleibt daher unklar, ob ein Gericht ihre Nutzung akzeptieren würde.
Training und das Erzeugen einer Antwort sind zudem unterschiedliche Vorgänge. Beim Training verarbeitet ein System Beispiele, um Muster zu erkennen. Beim Generieren erstellt es Text für einen Nutzer. Chen schlägt vor, die beiden Phasen gesetzlich getrennt zu regeln und dabei auch das Risiko zu berücksichtigen, dass Ausgaben geschützten Werken stark ähneln.
Das Amt für geistiges Eigentum im Wirtschaftsministerium prüft nach eigenen Angaben mögliche rechtliche Anpassungen. Das Ministerium für Digitales bezeichnet das Amt als zuständig für die Urheberrechtspolitik. Auch eine Untersuchung des Kontroll-Yuan empfahl, die Anpassung des Rechtsrahmens aktiv voranzutreiben, nachdem der Exekutiv-Yuan das Amt mit der Aufgabe betraut hatte.
Freiwillige Genehmigung statt Übertragung des Eigentums
Vor dem Verkehrsausschuss des Parlaments erklärte Minister Lin, das Programm für private Beiträge beginne mit Verlagen und E-Book-Plattformen. Gesucht würden vier Arten von Material:
- Bücher, deren urheberrechtlicher Schutz abgelaufen ist.
- Von Verlagen bereitgestellte Buchbeschreibungen.
- Ausgewählte Leseproben aus Büchern.
- Werke, die einzelne Autoren freiwillig lizenzieren.
Lin zufolge bat das Ministerium um die Erlaubnis, Werke für das KI-Training zu nutzen, wobei die Autoren das Urheberrecht behalten. Eine Lizenz erlaubt einer anderen Partei bestimmte Nutzungen zu vereinbarten Bedingungen. Ihr Umfang kann beispielsweise erlaubte Verwendungszwecke und die Nutzungsdauer festlegen.
Die Abgeordnete Lin Chu-yin von der Demokratischen Fortschrittspartei fragte, wie Beitragende vergütet würden, was bei einem späteren Widerruf der Erlaubnis geschehe und wie ihre Interessen geschützt würden, wenn aus dem Training weitere Produkte hervorgingen. Hung Yu-hsiang von der Taiwanischen Volkspartei schlug eine Servicestelle für Qualitätsprüfungen, Rechteklärung, entgeltlichen Erwerb und die Verwaltung verschiedener Lizenzkategorien vor.
Das Ministerium hat die Lizenz für das Taiwan Sovereign AI Training Corpus, Version 1, veröffentlicht und gemeinsam mit dem Amt für geistiges Eigentum Anwendungsbeispiele für Behörden erarbeitet. Einheitliche Bedingungen sollen wiederholte Verhandlungen und Urheberrechtsstreitigkeiten verringern. Außerdem plant das Ministerium Anreize für Beiträge. Vergütungssätze, Widerrufsregelungen und Bestimmungen für daraus entstehende Produkte sind in den öffentlich beschriebenen Vorschlägen noch nicht festgelegt.
Für entgeltliche Kooperation gibt es bereits ein kleines Beispiel
Lee Po-feng, Vorsitzender der Open Culture Foundation, hält es für unwahrscheinlich, dass Verlage ausreichend mitmachen, wenn sie wertvolles Material kostenlos bereitstellen sollen. Er verweist auf ein kleines Trainingsprojekt, das durch eine ausgehandelte Gegenleistung die Kooperation von Medien- und Bildungsplattformen gewann.
Die Vereinbarung umfasste eine einmalige Lizenzzahlung, eine auf zwei Jahre begrenzte Nutzung der Daten und einen bevorzugten Zugang zum daraus entstandenen Modell für die beteiligten Inhalteanbieter. Die Beitragenden erhielten Geld, eine klar festgelegte Nutzungsdauer und eine konkrete Gegenleistung.
Auch Wang Rong-wen, Vorsitzender des Verlags Yuan-Liou, spricht sich dafür aus, dass staatliche und kommerzielle Entwickler Mittel für Inhaltslizenzen einplanen. Die Angst vor Strafanzeigen schränke sowohl private Entwickler als auch Beamte ein, die KI-Projekte unterstützen wollten.
Lin erklärte dem Parlament, das langfristige Ziel der Regierung sei ein entgeltlicher Zugang für große KI-Unternehmen. Urheberrechtsstreitigkeiten rund um neue Technologien könnten drei bis fünf Jahre dauern. Deshalb beginne das Ministerium mit Material, bei dem es weniger Streit gebe. Seine Zeitangabe bezog sich auf die wahrscheinliche Dauer der Kontroversen, nicht auf eine Frist für ein Gesetz oder ein Vergütungsmodell.
Gesetzliche Ausnahmen und Sammellizenzen als konkurrierende Ansätze
Chen schlägt ein eigenes Kapitel zu KI im taiwanischen Urheberrechtsgesetz vor. Es soll eine Ausnahme für Text- und Data-Mining schaffen, die Offenlegung von Trainingsquellen vorschreiben und das Strafverfolgungsrisiko für zulässige Aktivitäten verringern.
Text- und Data-Mining bezeichnet den Einsatz von Software, um große Materialmengen zu analysieren und Muster zu erkennen. Die Europäische Union, Japan und Singapur haben Ausnahmen für bestimmte Formen dieser Tätigkeiten vorgesehen, allerdings mit unterschiedlichen Regeln und Bedingungen. Chen hält diese Ansätze für mögliche Vorbilder für die Debatte in Taiwan.
Lee schlägt einen früheren Schritt auf Verwaltungsebene vor: Leitlinien dazu, welche Trainingsnutzungen die Behörden als zulässige Nutzung ansehen und welche ein Verletzungsrisiko bergen. Als Beispiel nennt er die Agentur für kulturelle Angelegenheiten Japans, deren Checkliste und Leitlinien zum KI-Urheberrecht aus dem Jahr 2024 Entwicklern und Kreativen die Erwartungen der Behörden praxisnah vermitteln.
Chen regt außerdem Sammellizenzen an und verweist auf die Musikurheberrechtsgesellschaft von Chinesisch-Taipeh, bekannt als MÜST. Bei diesem Modell verwaltet eine Organisation Genehmigungen für viele Rechteinhaber, zieht Gebühren ein und verteilt die Zahlungen. Ein vergleichbarer Dienst für KI könnte den Aufwand verringern, einzeln mit Hunderten Verlagen oder Autoren zu verhandeln.
Chang Chung-hsin, außerordentlicher Assistenzprofessor am Institut für geistiges Eigentum der National Taipei University of Technology, vertritt eine andere Ansicht. Entwickler sollten nach dem geltenden Urheberrecht zahlen, statt Gesetzesänderungen anzustreben, argumentiert er. Seiner Ansicht nach sollten ausgehandelte Zugangsrechte zu wertvollen Verlags- und Nachrichteninhalten im Mittelpunkt der Lösung stehen.
TAIDE zeigt, warum sowohl Zugang als auch Ressourcen wichtig sind
Taiwans früherer Trustworthy AI Dialogue Engine, kurz TAIDE, zeigt, wie stark ein Modell von wenigen zugänglichen Sammlungen abhängen kann. Das Projekt wurde Anfang 2023 vom Nationalen Rat für Wissenschaft und Technologie eingerichtet; die erste Entwicklungsphase wurde mit mehr als 200 Millionen NT-Dollar gefördert.
TAIDE nutzte Trainingsmaterial von 15 staatlichen Stellen. Rund vier Millionen Artikel der Central News Agency machten 70 Prozent der Textdaten aus. Das Material wurde unter Berücksichtigung urheberrechtlicher Fragen beschafft. Es zeigt, wie ein geregelter Zugang zu umfangreichen Nachrichtenarchiven ein lokales Modell unterstützen kann.
Der leitende Forscher Yuh-Jye Lee vom Taiwan Information Security Center der Academia Sinica erläuterte den Wert einer heimischen Alternative:
Am Anfang können wir wahrscheinlich nicht mit den großen Systemen mithalten. Aber ein eigenes Dialogsystem bedeutet, dass wir zumindest eine Wahl haben.
Das frühe Modell basierte auf Llama 2 von Meta und hatte sieben Milliarden Parameter – Zahlenwerte, die ein Modell während des Lernens anpasst. Das Nationale Zentrum für Hochleistungsrechnen verfügte über 1.028 V100-Grafikprozessoren und kaufte im November 2023 für das Projekt neun H100-Prozessoren, während es seinen regulären Betrieb aufrechterhielt.
Das Projekt Demeter GPT der National Chung Hsing University, das landwirtschaftliche Fragen beantwortet, wechselte später von ChatGPT zu TAIDE. Der außerordentliche Professor Fan Yao-chung berichtete, dass sich die Genauigkeit chinesischer Antworten nach zusätzlichem Training verbessert habe. Zuvor hatte das Labor OpenAI pro Antwort ein bis zwei NT-Dollar gezahlt. Mit dem lokalen Betrieb von TAIDE entfielen die laufenden Kosten nun auf die eigenen Rechner und den Strom.
Taiwans Korpusinitiative setzt bei der Textversorgung an, auf der solche Anwendungen beruhen. Staatliche Wörterbücher und kulturelle Aufzeichnungen bilden eine Grundlage. Ein breiterer Zugang zu Verlagsinhalten, spezialisierten Lehrmaterialien und Journalismus hängt von Vereinbarungen ab, die Entwickler bezahlen können und die Inhalteanbieter akzeptieren.
Die wichtigsten Punkte
- Private Beitragende lieferten 111 von 7.161 Korpuseinträgen, rund 1,6 Prozent.
- Zum Start im Dezember 2025 kündigte die Regierung 600 Millionen Tokens an; bis September 2026 stieg die Zahl auf mehr als 2,4 Milliarden.
- Minister Lin zufolge ist die private Beteiligung freiwillig; die Autoren behalten das Urheberrecht.
- Nachrichteninhalte sind vom aktuellen Programm für private Beiträge ausgenommen. Das Ministerium strebt entgeltliche Vereinbarungen mit KI-Unternehmen an.
- Eine Strafanzeige vom Juli 2025 wegen 140.000 nicht genehmigten Nachrichtenartikeln verstärkte die Bedenken unabhängiger Entwickler.
- Zu den Vorschlägen gehören klarere Leitlinien zur zulässigen Nutzung, eine Ausnahme für Data-Mining, Sammellizenzen und direkte Zahlungen nach geltendem Recht.