Der Smartphone-Hersteller, der gerade die KI-Inferenz verändert hat
An einem Montagmorgen, der die Technologiebranche überraschte, tat Xiaomi etwas, womit nur wenige Beobachter gerechnet hatten. Das Unternehmen, das vor allem für erschwingliche Smartphones, Elektroroller und Luftreiniger bekannt ist, gab bekannt, eine wichtige Hürde bei der Geschwindigkeit künstlicher Intelligenz überwunden zu haben. Sein neuer Bereitstellungsmodus MiMo-V2.5-Pro-UltraSpeed erzeugt bei einem Modell mit einer Billion Parametern mehr als 1.000 Tokens pro Sekunde und erreichte in Live-Demonstrationen Spitzenwerte von fast 1.200 Tokens. Es handelt sich nicht um eine abgespeckte Modellversion. Es ist das vollständige Flaggschiff MiMo-V2.5-Pro, ein KI-System auf Spitzenniveau, das bei Programmier-Benchmarks mit Claude Opus konkurriert.
Inhalt
- Der Smartphone-Hersteller, der gerade die KI-Inferenz verändert hat
- Was 1.000 Tokens pro Sekunde tatsächlich bedeuten
- Wie Xiaomi die Hersteller maßgeschneiderter Spitzenchips überholt hat
- Die drei Techniken hinter UltraSpeed
- Warum Geschwindigkeit völlig neue Anwendungen ermöglicht
- Zugang, Preise und Open-Source-Veröffentlichung
- Xiaomis stiller Aufstieg zur KI-Großmacht
- Auf einen Blick
Die Ankündigung ist nicht nur wegen der Geschwindigkeit verblüffend. Es ist auch die dafür eingesetzte Hardware. Xiaomi erreichte diese Werte mit einem einzelnen Standardknoten mit acht handelsüblichen GPUs, wie sie jeder große Cloud-Anbieter bereitstellt. Kein maßgeschneiderter Siliziumchip. Keine Spezialchips in der Größe eines Esstellers. Nur Softwareinnovationen auf Hardware, die Entwickler noch heute mieten können.
Parameter sind die internen numerischen Gewichtungen, die festlegen, wie ein KI-Modell Informationen verarbeitet. Eine Billion Parameter bedeutet, dass das Modell außerordentlich komplexe Muster in Texten und Code erkennen kann. Tokens sind die Textabschnitte, die das Modell liest und schreibt, ungefähr drei Viertel eines Wortes. Mehr als 1.000 davon pro Sekunde zu erzeugen bedeutet, dass dieses gewaltige Gehirn mit einer Geschwindigkeit arbeitet, die bislang ohne spezielle Hardware als unmöglich galt.
Jahrelang wurde das Rennen um schnellere KI-Inferenz von gut finanzierten Chip-Start-ups mit maßgeschneiderten Siliziumdesigns geprägt. Xiaomi hat nun bewiesen, dass clevere Entwicklung auf Standardhardware sie alle überholen kann. Der Erfolg wirft die entscheidende Frage auf, ob teure Spezialhardware nötig ist, wenn intelligente Softwareoptimierung auf leicht zugänglicher Infrastruktur bessere Ergebnisse liefern kann.
Was 1.000 Tokens pro Sekunde tatsächlich bedeuten
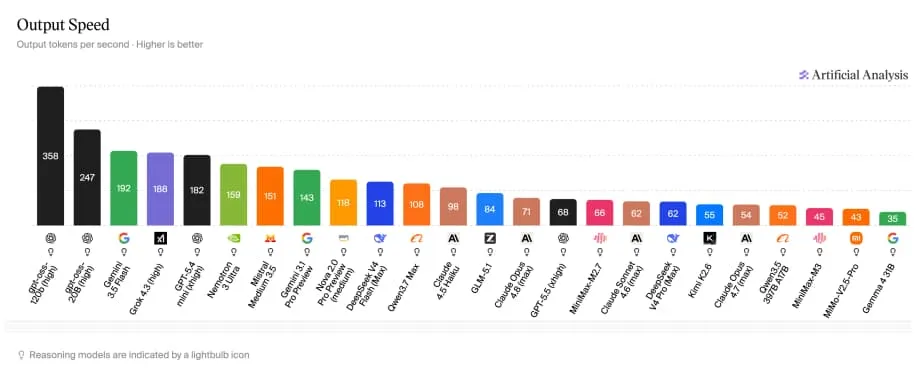
Um zu verstehen, warum diese Zahl wichtig ist, lohnt sich ein Blick auf die Erfahrungen heutiger Nutzer im Alltag. Benchmark-Daten von Artificial Analysis zufolge erzeugt GPT-5.5, das Modell hinter den meisten ChatGPT-Unterhaltungen, ungefähr 68 Tokens pro Sekunde. Claude Opus 4.6 kommt auf etwa 71 Tokens pro Sekunde, während Anthropics leichteres Haiku-Modell 98 erreicht. Googles Gemini Flash ist mit 192 Tokens pro Sekunde schneller. MiMo-V2.5-Pro-UltraSpeed schafft bei einem Modell mit einer Billion Parametern 1.000 Tokens pro Sekunde und ist damit fast fünfzehnmal schneller als die Chatbots, die Millionen Menschen täglich nutzen.
Der Unterschied zwischen 68 und 1.000 ist nicht bloß ein kleiner Fortschritt. Er steht für eine völlig andere Leistungsklasse. Bei den heutigen Verbrauchergeschwindigkeiten warten Nutzer mehrere Sekunden, bis ein Absatz Text erscheint. Bei Xiaomis neuer Geschwindigkeit kann eine ganze Seite Analyse fast augenblicklich entstehen. Für Entwickler, die Programmieragenten einsetzen, wird aus einem verzögerten Hin und Her eine Zusammenarbeit, die sich wie Echtzeit anfühlt.
Tokens sind die grundlegende Recheneinheit großer Sprachmodelle. Wenn Sie eine Eingabe schreiben, zerlegt das Modell Ihren Text zur Verarbeitung in Tokens. Bei der Antwort erzeugt es die Tokens einzeln und sagt jedes auf Grundlage aller vorherigen voraus. Je schneller ein Modell Tokens erzeugen kann, desto unmittelbarer wirkt es und desto mehr Aufgaben kann es innerhalb enger Zeitlimits erledigen. Die Geschwindigkeit bestimmt auch, wie viele Anfragen ein Server gleichzeitig bearbeiten kann, und wirkt sich damit unmittelbar auf Kosten und Skalierbarkeit für Unternehmen aus.
Schon das frühere Flash-Modell von MiMo-V2.5-Pro erzeugte Antworten mit 150 Tokens pro Sekunde, also ungefähr 110 Wörtern pro Sekunde. Das ist schneller, als ein Mensch lesen oder sprechen kann. UltraSpeed verschiebt diese Obergrenze deutlich nach oben. Die Generierungsrate übertrifft die menschliche Denkgeschwindigkeit und ermöglicht maschinengesteuerte Arbeitsabläufe, die zuvor nicht möglich waren.
Wie Xiaomi die Hersteller maßgeschneiderter Spitzenchips überholt hat
Die Suche nach Lösungen für den Engpass bei der KI-Inferenzgeschwindigkeit hat Investitionen in Höhe von Hunderten Millionen Dollar in Unternehmen gelenkt, die Spezialhardware entwickeln. Cerebras entwarf einen Chip im Wafermaßstab, ungefähr so groß wie ein Essteller, mit 44 GB On-Chip-Speicher, um Bandbreitenbeschränkungen zu beseitigen. Damit wurden 969 Tokens pro Sekunde erreicht, eine beachtliche Leistung, allerdings mit Metas Llama 3.1 405B, einem Modell mit 405 Milliarden Parametern. Es ist weniger als halb so groß wie MiMo-V2.5-Pro. Groq entwickelte eine maßgeschneiderte Architektur für eine Language Processing Unit, die je nach Modell 300 bis 750 Tokens pro Sekunde erreicht. Keines der beiden Systeme läuft auf der Standard-Cloud-Hardware, die Entwickler bei Anbietern wie AWS mieten können.
Xiaomis Ansatz stellt dieses Modell vollständig auf den Kopf. Gemeinsam mit dem Inferenzpartner TileRT erzielte das Unternehmen seinen Rekord durch das, was es als extremes Model-System-Codesign bezeichnet: eine koordinierte Optimierung sowohl des KI-Modells als auch der Software-Engine, die es bereitstellt. Das Ergebnis ist ein Modell mit einer Billion Parametern, das auf handelsüblichen GPUs schneller läuft als auf Spezialchips. Sollten unabhängige Tests diese Benchmarks bestätigen, zeigt der Erfolg, dass Softwareinnovationen Hardwarebeschränkungen überwinden können, für die viele bislang maßgeschneiderte Chips für nötig hielten.
Diese Entwicklung hat spürbare wirtschaftliche Bedeutung. Maßgeschneiderte Siliziumchips erfordern enorme Investitionen, lange Entwicklungszyklen und eine spezialisierte Fertigung. Handelsübliche GPUs profitieren von Skaleneffekten, breiter Verfügbarkeit und kontinuierlichen Verbesserungen durch NVIDIA und andere Hersteller. Indem Xiaomi das Inferenzproblem mit Software löst, hat das Unternehmen den Zugang zu Geschwindigkeiten möglicherweise demokratisiert, die bislang gut finanzierten Forschungslaboren mit proprietärer Hardware vorbehalten waren.
Die Veröffentlichung des FP4-DFlash-Checkpoints auf Hugging Face eröffnet eine weitere Möglichkeit, diesen Zugang zu verbreitern. Forschende und Entwickler weltweit können das zugrunde liegende Modell nun untersuchen, testen und anpassen, ohne proprietäre Hardware kaufen oder Unternehmenslizenzen abschließen zu müssen. Die Überprüfung durch die Community wird zeigen, ob sich diese Techniken breit auf andere Modelle und Anwendungsfälle übertragen lassen.
Die drei Techniken hinter UltraSpeed
Der Durchbruch beruht auf drei aufeinander abgestimmten Techniken. Keine davon erzielt den Geschwindigkeitsrekord allein, doch gemeinsam heben sie die Leistung über die Marke von 1.000 Tokens.
Die erste Technik ist die FP4-Quantisierung. Die meisten großen Modelle arbeiten mit einer numerischen Präzision von 16 oder 8 Bit. Das bedeutet, dass jeder Parameter zwei beziehungsweise ein Byte Speicher benötigt. Xiaomi komprimiert die Experten-Schichten, die den Großteil der Billion Parameter ausmachen, auf eine Präzision von 4 Bit. Dadurch sinkt der Speicherbedarf und die Bandbreite wird weniger belastet, sodass sich Daten schneller durch das System bewegen können. Bei der Quantisierung besteht das Risiko eines Qualitätsverlusts, da geringere Präzision die Schlussfolgerungsfähigkeit eines Modells beeinträchtigen kann. Xiaomi umgeht dieses Problem mit einem gezielten Eingriff: Komprimiert werden nur die Experten-Schichten, während der Rest des Modells mit voller Präzision erhalten bleibt. Das Unternehmen bezeichnet den dadurch entstehenden Qualitätsverlust als nahezu null.
Die zweite Technik ist das spekulative Decoding DFlash. Beim herkömmlichen spekulativen Decoding schätzt ein kleineres Entwurfsmodell schnell die nächsten Tokens, die das große Modell anschließend parallel überprüft. DFlash lässt den sequenziellen Entwurfsschritt ganz weg. Stattdessen füllt es einen ganzen Block maskierter Positionen in einem einzigen Vorwärtsdurchlauf aus. Bei Programmieraufgaben akzeptiert das große Modell pro Überprüfungsrunde durchschnittlich 6,3 der 8 vorgeschlagenen Tokens. Das bedeutet, dass sechs Tokens in einem Schritt statt nur einem weiterverarbeitet werden: eine enorme Beschleunigung der Generierung.
Die dritte Komponente ist TileRT selbst, die Inferenz-Engine, die die gesamte Rechenpipeline fortlaufend in der GPU hält. Herkömmliche Bereitstellungssysteme starten einzelne Operatoren oft nacheinander, wodurch kleine Lücken bei der Ausführung entstehen. TileRT beseitigt diesen Startaufwand für jeden einzelnen Operator und sorgt dafür, dass die Daten ohne Unterbrechung weiterfließen. In Kombination mit den komprimierten Modellgewichten und der fortschrittlichen Decoding-Strategie hält die Engine auf Standardhardware Durchsatzraten aufrecht, die zuvor unerreichbar waren.
Xiaomi nennt diese Kombination extremes Model-System-Codesign, und die Bezeichnung trifft es. Jede Optimierungsebene verstärkt die anderen. So entsteht ein Ganzes, das über das hinausgeht, was jede einzelne Technik für sich leisten könnte.
Warum Geschwindigkeit völlig neue Anwendungen ermöglicht
Rohe Benchmarkwerte sind bedeutungslos, wenn sie nichts Neues ermöglichen. Mit 1.000 Tokens pro Sekunde öffnet MiMo-V2.5-Pro-UltraSpeed Türen, die langsameren Systemen weiterhin fest verschlossen bleiben.
Man denke daran, wie Entwickler große Sprachmodelle derzeit für komplexe Aufgaben einsetzen. Bei einem schwierigen Programmierproblem wartet ein Nutzer üblicherweise auf eine Antwort und hofft, dass sie stimmt. Mit UltraSpeed kann derselbe Nutzer innerhalb desselben Echtzeitfensters Dutzende Lösungswege parallel durchspielen und sie im Hintergrund automatisch überprüfen und korrigieren lassen. Das Modell kann mehrere Lösungen gleichzeitig erkunden, statt sich auf eine einzige Gedankenkette festzulegen. Dadurch wird aus einer sequenziell arbeitenden KI grundlegend ein paralleler Problemlöser.
Branchen mit strengen Latenzanforderungen können unmittelbar profitieren. Betrugserkennungssysteme müssen Transaktionen innerhalb von Millisekunden bewerten. Bei der Generierung von Handelssignalen in Echtzeit sind Verzögerungen von mehreren Sekunden nicht tragbar. Autonome Agentenschleifen, in denen KI-Systeme in schnellen Zyklen beobachten, entscheiden und handeln, benötigen Geschwindigkeiten, die Verbraucher-Chatbots nicht bieten können. Bei 68 Tokens pro Sekunde stoßen diese Anwendungen auf frustrierende Engpässe. Mit 1.000 Tokens pro Sekunde werden sie auf einer gewöhnlichen Cloud-Infrastruktur praktikabel.
Auch im alltäglichen Programmieralltag verändert die Geschwindigkeit das Erleben. Entwickler starrten bislang auf Bildschirme und warteten darauf, dass die Inferenz abgeschlossen war. Bei einer Ausgabe von annähernd oder mehr als 1.000 Tokens pro Sekunde verschwindet die Verzögerung praktisch. Aus dem Anfragen und Warten wird eine echte Zusammenarbeit mit einem KI-Partner in Echtzeit. Auch Gesundheitsanwendungen, die eine schnelle Analyse von Patientendaten erfordern, und Anlageplattformen, die Live-Marktdaten verarbeiten, profitieren unmittelbar von dieser Reaktionsgeschwindigkeit.
Zugang, Preise und Open-Source-Veröffentlichung
Xiaomi hält diese Technologie nicht unter Verschluss. Das Unternehmen hat einen zeitlich begrenzten API-Test vom 9. bis zum 23. Juni 2026 gestartet. Der Zugang erfolgt auf Antrag, eine Zusage ist nicht garantiert. Vorrang haben Unternehmenskunden und professionelle Entwickler mit konkretem geschäftlichem Bedarf. Da die Ressourcen für schnelle Inferenz begrenzt sind, kann jedes Konto sich bis zu zehnmal täglich in die Warteschlange einreihen. Jede Sitzung ist auf 30 Minuten begrenzt. Sitzungen, die länger als fünf Minuten inaktiv sind, werden automatisch freigegeben.
Die Preisgestaltung spiegelt den Premiumcharakter der Geschwindigkeit wider. UltraSpeed kostet das Dreifache des Standardtarifs für MiMo-V2.5-Pro, bietet aber ungefähr die zehnfache Generierungsgeschwindigkeit. Zum Vergleich: MiMo-V2.5-Pro ist bereits deutlich günstiger als Claude Opus. Der Preis liegt bei ungefähr 0,43 US-Dollar pro Million Eingabetokens und 0,87 US-Dollar pro Million Ausgabetokens. Bei Opus sind es 5 US-Dollar für eine Million Eingabetokens und 25 US-Dollar für eine Million Ausgabetokens. Selbst zum dreifachen Tarif ist Xiaomis beschleunigtes Angebot damit deutlich günstiger als viele konkurrierende Spitzenmodelle.
Entwickler, die die Technologie lieber direkt testen möchten, können auf den von Xiaomi als Open Source auf Hugging Face veröffentlichten MiMo-V2.5-Pro-FP4-DFlash-Checkpoint zugreifen. TileRT hat zudem ausgewählte Module auf GitHub veröffentlicht. Damit lädt das Unternehmen die globale Forschungsgemeinschaft dazu ein, die Benchmarks zu überprüfen, mit der Architektur zu experimentieren und die Techniken möglicherweise für andere Modelle anzupassen. Eine breit veröffentlichte unabhängige Überprüfung durch Dritte liegt bislang nicht vor. Tests der Community anhand dieser offenen Veröffentlichungen werden in den kommenden Wochen zeigen, wie belastbar die Ergebnisse sind.
Xiaomis stiller Aufstieg zur KI-Großmacht
Für die meisten Verbraucher ist Xiaomi nach wie vor eine Marke für erschwingliche Elektronik. Das Unternehmen hat weltweit Millionen Smartphones, Elektroroller und Luftreiniger verkauft. Dieses Verbraucherimage hat eine stetig wachsende KI-Sparte überdeckt, die in der Branche bis jetzt kaum Beachtung fand.
MiMo-V2.5-Pro erreichte bei den meisten Programmier-Benchmarks bereits bei seiner Einführung im April das Niveau von Claude Opus. UltraSpeed führt kein neues oder abgespecktes Modell ein. Es beschleunigt dieselbe Intelligenz auf Spitzenniveau, die bereits mit den führenden Modellen konkurrierte. Die Smartphone-Marke hat damit KI-Fähigkeiten aufgebaut, die mit denen spezialisierter Labore mithalten, und bietet sie zugleich zu Preisen an, die deutlich unter deren Niveau liegen.
Sollten die Geschwindigkeitsangaben einer unabhängigen Prüfung standhalten, wäre Xiaomi etwas Außergewöhnliches gelungen: ohne die Hunderte Millionen Dollar, die Unternehmen wie Cerebras und Groq in maßgeschneiderte Siliziumchips investieren mussten. Das Unternehmen hätte gezeigt, dass Softwareoptimierung auf handelsüblicher Hardware eine branchenführende Leistung ermöglichen kann. Das würde die Annahmen darüber verändern, woher KI-Fähigkeiten kommen und welche Akteure an der Spitze konkurrieren können. Ein Unterhaltungselektronik-Konzern aus Peking ist gerade in die Spitzengruppe der KI-Infrastruktur-Innovatoren aufgestiegen, und zwar mit Standard-GPUs statt maßgeschneiderten Siliziumchips.
Auf einen Blick
- Xiaomis MiMo-V2.5-Pro-UltraSpeed erzeugt bei einem Modell mit einer Billion Parametern mehr als 1.000 Tokens pro Sekunde und nutzt dafür lediglich acht handelsübliche Standard-GPUs. Maßgeschneiderte Siliziumchips sind nicht erforderlich.
- Das Modell ist ungefähr fünfzehnmal schneller als GPT-5.5 und Claude Opus. Möglich machen das FP4-Quantisierung, spekulatives Decoding mit DFlash und die Inferenz-Engine TileRT.
- Vom 9. bis zum 23. Juni 2026 läuft ein zeitlich begrenzter API-Test. Er kostet das Dreifache des Standardtarifs für MiMo und bietet ungefähr die zehnfache Generierungsgeschwindigkeit. Vorrang erhalten Unternehmen und professionelle Entwickler.
- Xiaomi hat den FP4-DFlash-Checkpoint als Open Source auf Hugging Face veröffentlicht. So kann die Community die Techniken überprüfen und anpassen.
- Wird der Durchbruch unabhängig bestätigt, zeigt er, dass Softwareoptimierung auf Standard-Cloud-Hardware teure Lösungen mit maßgeschneiderten Chips von spezialisierten KI-Hardware-Unternehmen übertreffen kann.