Eine neue Vision für die Spielsteuerung
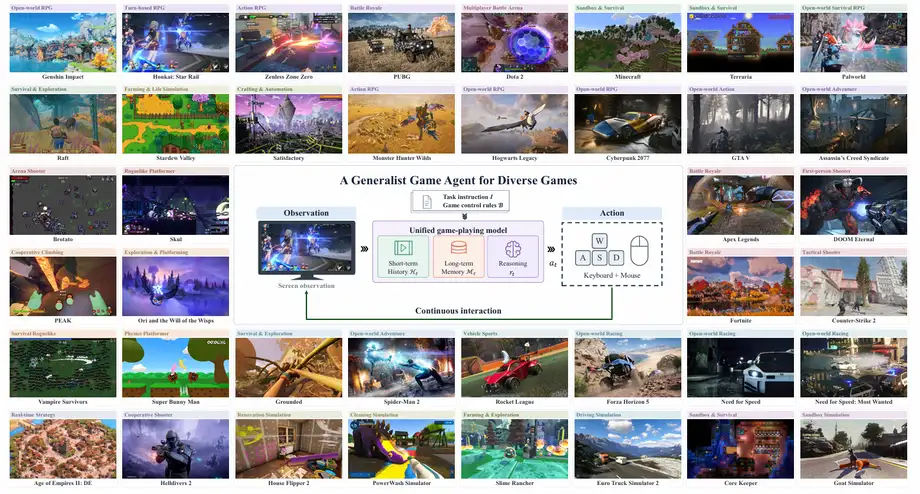
Forscher von miHoYo haben in Zusammenarbeit mit dem Honkai-KI-F&E-Team und mehreren akademischen Einrichtungen ein Vision-Language-Action-Grundlagenmodell namens Gamer vorgestellt. Das Projekt wendet sich von herkömmlichen Systemen ab, die auf interne Spielprogrammierschnittstellen oder modifizierte Speicherzustände angewiesen sind. Stattdessen verarbeitet das Framework rohe visuelle Eingaben von Spielbildschirmen und übersetzt diese Beobachtungen direkt in Standard-Tastatur- und Mausbefehle. Das Entwicklungsteam hat die zugrundeliegende Architektur in einem Preprint mit dem Titel Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent detailliert dargelegt, das am 13. November 2026 auf arXiv veröffentlicht wurde und dessen Einreichungsverlauf am 18. November 2026 mit einer finalen Überarbeitung abgeschlossen wurde. Zu den beteiligten Forschungseinrichtungen gehören die National University of Singapore, die Tsinghua University, die University of Chinese Academy of Sciences, die University of Science and Technology of China und die Xi'an Jiaotong University. Die Projektleitung umfasst prominente Persönlichkeiten wie David Jiang, Produzent mehrerer großer Titel des Honkai-Franchise, und Zheng Yinhe, Leiter des technischen Teams der Honkai-Serie für künstliche Intelligenz für nicht spielbare Charaktere und Gameplay.
Inhalt
Im Gegensatz zu herkömmlichen Software-Agenten, die einen privilegierten Zugriff auf den Spielcode erfordern, interagiert Gamer mit digitalen Umgebungen ähnlich wie ein menschlicher Spieler. Das Modell erfasst Bildwiederholungen mit einer Frequenz von fünf Hertz und nutzt diese visuellen Signale zusammen mit Task-Anweisungen und dem Beobachtungsverlauf, um geeignete Aktionen zu bestimmen. Diese Entscheidungen äußern sich als eine Reihe von Low-Level-Tastaturzuständen und Mausbewegungen, die in einem Steuerrhythmus von dreißig Hertz ausgeführt werden. Indem die Benutzerinteraktion als ein gemeinsames Format behandelt wird, das herkömmliche grafische Benutzeroberflächen und komplexe dreidimensionale simulierte Welten umfasst, bietet das Framework einen einheitlichen Ansatz für digitale Navigation und Ausführung.
Trainingsepipelines und mehrstufiges Lernen
Der Aufbau eines autonomen Agenten, der in der Lage ist, ein lang andauerndes Gameplay aufrechtzuerhalten, erfordert einen Schritt über die standardmäßige multimodale Instruktionsabstimmung hinaus. Das Forschungsteam implementierte eine umfassende Trainingsepipeline, die in drei distincte Phasen unterteilt ist. Die initiale Phase umfasst ein fortgesetztes Vortraining mit einem großen Datensatz, der aus zehntausenden Stunden an gerätebasierten Tastatur- und Mausinteraktionstrajektorien besteht. Diese Interaktionsaufzeichnungen erstrecken sich über simulierte Spiele und verkörperte Umgebungen, wodurch das Modell Umweltdynamiken und visuell-motorische Korrelationen über verschiedene digitale Einstellungen hinweg erlernen kann. Der Projektdokumentation zufolge umfasst das Trainingstrajektorien aus Quellen wie VPT, D2E, OpenP2P und aufgezeichnetem Filmmaterial von Honkai: Star Rail.
Dem fortgesetzten Vortraining folgt eine Instruktionsabstimmung mit spärlicher Argumentation (Sparse-Reasoning). In dieser Phase lernt das Framework, die unmittelbare motorische Ausführung mit einer bewussten Planung in Einklang zu bringen. Anstatt für jeden Frame fortlaufend erklärenden Text zu generieren, führt das Modell Routinebewegungen direkt aus und hält sich gleichzeitig explizite Begründungsblöcke für wichtige Entscheidungspunkte wie Rätselsequenzen oder erzählerische Entscheidungen vor. Die finale Trainingsphase führt eine Online-Reinforcement-Learning-Methode ein, die als Temporal-Aware Group Relative Policy Optimization bekannt ist. Diese Technik bewältigt die Herausforderungen begrenzter Kontextfenster, akkumulierter Rollout-Fehler bei langen Aufgabensequenzen und spärlicher Belohnungen, indem sie Trajektoriesegmente durch persistente Speicherzusammenfassungen verknüpft.
Verwaltung von Speicher und Langstreckenausführung
Die Ausführung von Aufgaben, die sich über Stunden des Gameplays erstrecken, stellt erhebliche Hürden im Hinblick auf den Gedächtnisabruf und die Kontextgrenzen dar. Wenn ein Agent weitläufige virtuelle Welten erkundet, schwinden frühe Interaktionen schnell aus dem aktiven Kontextfenster, was zu Navigationsfehlern oder vergessenen Zielen führt. Um den Fortschritt der Aufgabe aufrechtzuerhalten, ohne das System mit unbegrenzt wachsenden Gesprächsverläufen zu überlasten, integrierten die Forscher einen persistenten Speichermechanismus. Während die Aufgaben voranschreiten und ältere Interaktionen aus dem aktiven Kontext fallen, generiert das Modell kompakte Zusammenfassungen, die abgeschlossene Meilensteine, fehlgeschlagene Versuche, wichtige Standorte und nachfolgende Pläne aufzeichnen.
Die Wirksamkeit dieses mehrstufigen Trainings- und Speicherverwaltungsansatzes wurde durch strenge Tests in spezifischen Rollenspielszenarien bewertet. Bei bewerteten Nebenquests in Honkai: Star Rail zeigten die Meilenstein-Abschlussraten in den Trainingsphasen eine stetige Verbesserung. Bei der Nebenquest mit dem Titel Opportunity Makes the Thief (Part I) stiegen die Meilenstein-Abschlussraten nach dem fortgesetzten Vortraining von 34,4 % auf 72,2 % nach einem überwachten Feintuning und erreichten durch die Anwendung von Online-Reinforcement-Learning 80,0 %. Ebenso stiegen die Abschlussraten bei der Nebenquest Bestial Ferocity von 47,9 % auf 69,1 % und erreichten nach der Reinforcement-Learning-Optimierung schließlich 83,6 %. Über einen bewerteten Satz von vierzig ungewohnten Minispiel-Aufgaben hinweg erzielte eine als Gamer-RL bezeichnete Version eine durchschnittliche Erfolgsquote von 49,7 %.
Echtzeit-Inferenz und Streaming-Architektur
Die Aufrechterhaltung einer hohen Leistung während der Echtzeit-Interaktion erfordert, dass die Inferenzlatenz deutlich innerhalb der Toleranzschwellen interaktiver Software gehalten wird. Um Verzögerungen zu vermeiden, die dazu führen würden, dass ein Agent dynamische Ereignisse in schnelllebigen Umgebungen verpasst, entwickelte das Entwicklungsteam ein Cloud-Edge-Serving-System namens Streaming-vLLM. Diese Inferenz-Engine kombiniert persistente Kontextwiederverwendung, verifizierte spekulative Dekodierung und eine vorzeitige Aktionsabfertigung, um parallele Rollouts effizient zu verarbeiten. Die persistente Kontextwiederverwendung vermeidet redundante Berechnungen historischer Bildschirmzustände, indem Key-Value-Caches über Frames hinweg beibehalten werden, während die vorzeitige Aktionsabfertigung die erste gültige Gruppe von Tastaturbefehlen an den Spielclient überträgt, bevor nachfolgende Token die Generierung beenden.
Leistungs-Benchmarks, die im Projektrepository detailliert beschrieben werden, veranschaulichen die Auswirkungen dieser Optimierungen. In einer Umgebung mit NVIDIA-H200-Hardware und einer Modellkonfiguration basierend auf Qwen3.5-35B-A3B mit einem auf vier gesetzten Tensor-Parallelismus verzeichnete das Basis-Setup eine End-to-End-Anfragelatenz von 1.306,00 Millisekunden. Nach der Anwendung der Streaming-vLLM-Optimierungen sank diese Anfragelatenz auf 65,12 Millisekunden. Diese Reduzierung der Ausführungszeit ermöglicht es dem System, gleichzeitige Online-Auswertungen zu unterstützen und während komplexer räumlicher Navigations- und Kampfsequenzen reaktionsfähige Steuerschleifen aufrechtzuerhalten.
Forschungsumfang und praktische Grenzen
Die Veröffentlichung dieses Forschungs-Frameworks hat eine breite Diskussion über seine potenziellen Fähigkeiten und beabsichtigten Anwendungen ausgelöst. Projektdokumentationen und öffentliche Äußerungen des Forschungsteams betonen, dass Gamer ein akademisches Explorationsprojekt ist, das darauf abzielt, das Verhalten generalistischer Agenten in interaktiven Umgebungen zu untersuchen, und kein autorisiertes kommerzielles Werkzeug zur Automatisierung von Spieler-Accounts oder zur Generierung von Wettbewerbsvorteilen darstellt. Um datenschutzrechtliche Überlegungen zu adressieren, hielt das Team die spezifischen Trainingsdaten und Modellgewichte zurück, die mit urheberrechtlich geschützten Titeln verbunden sind, und machte lediglich grundlegende Vortrainingsdateien und Systemdokumentationen über Ressourcen wie das Gamer GitHub-Repository öffentlich zugänglich.
Mögliche praktische Anwendungen, die von den Entwicklern umrissen wurden, konzentrieren sich primär auf den industriellen und entwicklungstechnischen Nutzen statt auf die Verbraucherautomatisierung. Automatisierte Testpipelines könnten solche Modelle nutzen, um Stresstests über verzweigte Erzählpfade und weitläufige virtuelle Welten hinweg durchzuführen und Implementierungsfehler schneller zu identifizieren als herkömmliche manuelle Verifizierungsmethoden. Darüber hinaus bieten die zugrundeliegenden Prinzipien Einblicke in die Barrierefreiheitshilfe und die Forschung zur Mensch-Computer-Interaktion und ebnen den Weg für Agenten, die in der Lage sind, verschiedene Eingabemodalitäten in präzise digitale Aktionen zu übersetzen.
Das Wesentliche
- Das Forschungs-Framework wurde vom Honkai-KI-F&E-Team bei miHoYo in Partnerschaft mit akademischen Einrichtungen wie der National University of Singapore und der Tsinghua University entwickelt.
- Detaillierte Erkenntnisse und architektonische Beschreibungen sind im Preprint Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent dokumentiert.
- Das System erfasst rohe Bildschirmbeobachtungen mit fünf Hertz und gibt native Tastatur- und Mausbefehle aus, ohne interne Programmierschnittstellen oder Speicher-Hooks zu erfordern.
- Die Trainingsverfahren umfassen ein fortgesetztes Vortraining über zehntausende von Stunden an Interaktionstrajektorien, Instruktionsabstimmung mit spärlicher Argumentation und Temporal-Aware Group Relative Policy Optimization.
- Die benutzerdefinierte Inferenz-Engine Streaming-vLLM reduzierte die Anfragelatenz bei Tests mit NVIDIA-H200-Hardware von 1.306,00 Millisekunden auf 65,12 Millisekunden.
- Das Forschungsteam betont, dass das Projekt als akademische Studie dient, die auf Anwendungen wie automatisierte Tests und Barrierefreiheitsforschung abzielt, und kein kommerzielles Werkzeug zur Gameplay-Automatisierung darstellt.